Chapter 3 of 9Chương 3/9 5 min5 phút
What an AI application runs onỨng dụng AI chạy trên những gì
The answer a large chatbot gives seems to come from the phone in your hand. Some small models do run on the phone itself. For the largest ones, though, the answer usually comes from a building full of servers, where thousands of processors, memory chips and network cards have to work as one machine.
Câu trả lời của một chatbot lớn có vẻ như đến từ chính chiếc điện thoại trong tay bạn. Một số mô hình nhỏ quả thật chạy ngay trên điện thoại. Còn với những mô hình lớn nhất, câu trả lời thường đến từ một tòa nhà đầy máy chủ, nơi hàng nghìn bộ xử lý, chip nhớ và card mạng phải phối hợp như một cỗ máy duy nhất.
In this chapter
Trong chương này
- What an AI application really runs on: servers, GPUs, memory, storage and networking
- What an eight-GPU server holds, and how its memory and links have grown across three generations of GPU
- Why AI lifts memory and networking chipmakers too, not only GPU designers
- How GPU virtualization lets several applications share one GPU and cuts the cost of running AI
- Một ứng dụng AI thực sự chạy trên những gì: máy chủ, GPU, bộ nhớ, thiết bị lưu trữ và mạng
- Bên trong một GPU server gắn tám GPU có gì, và bộ nhớ cùng đường kết nối của nó đã được nâng cấp ra sao qua ba thế hệ GPU
- Vì sao làn sóng AI kéo theo cả các hãng làm chip nhớ và chip mạng, không riêng gì các hãng thiết kế GPU
- Ảo hóa GPU (GPU virtualization) giúp nhiều ứng dụng dùng chung một GPU và giảm chi phí vận hành AI như thế nào
An AI application runs on many chips at once
Một ứng dụng AI chạy trên rất nhiều con chip
An AI application runs on many chips at once. When it runs in the cloud, it may run on servers, each holding one or more CPUs, one or more GPUs, memory and storage, all joined by networking equipment. The CPU is the general-purpose processor that runs the operating system and keeps everything organised; the GPU does the heavy, repetitive arithmetic that AI models are made of.
Một ứng dụng AI chạy trên rất nhiều con chip cùng lúc. Khi chạy trên đám mây, nó có thể chạy trên các máy chủ, mỗi máy gồm một hoặc vài CPU (Central Processing Unit), một hoặc nhiều GPU, bộ nhớ và thiết bị lưu trữ, tất cả nối với nhau qua thiết bị mạng. CPU là bộ xử lý đa năng, lo chạy hệ điều hành và điều phối mọi việc; còn GPU (Graphics Processing Unit) gánh những phép tính nặng, lặp đi lặp lại, vốn là phần việc chủ yếu của một mô hình AI.
Size decides how much of this is needed. A small model can run on a laptop or a phone. Training a large model can take thousands or even tens of thousands of GPUs, far more than one server can hold, so the work is spread across many servers. Running it for many users afterwards also needs many servers, how many depending on the model and the traffic. Those servers have to be linked by fast networking and backed by storage systems built for the job. The buildings that house them are data centers.
Kích thước mô hình quyết định cần bao nhiêu thứ như vậy. Một mô hình nhỏ có thể chạy trên máy tính xách tay hay điện thoại. Training (huấn luyện) một mô hình lớn có thể cần hàng nghìn, thậm chí hàng chục nghìn GPU, vượt xa sức chứa của một máy chủ, nên công việc phải chia ra cho nhiều máy chủ. Sau đó, đưa mô hình vào phục vụ nhiều người dùng cũng cần nhiều máy chủ, nhiều đến đâu thì tùy mô hình và lượng truy cập. Các máy chủ ấy phải nối với nhau bằng mạng tốc độ cao và dựa vào những hệ thống lưu trữ chuyên dụng. Tòa nhà chứa chúng chính là data center.
Getting all of that to work as one system starts with the hardware. The companies that make each component have to design them to fit together, and then the pieces have to be connected into systems that run smoothly side by side.
Để tất cả vận hành như một hệ thống, việc đầu tiên nằm ở phần cứng. Các công ty làm ra từng linh kiện phải thiết kế sao cho chúng khớp với nhau, rồi các mảnh ghép ấy còn phải được nối thành những hệ thống chạy ăn khớp.
What a GPU server holds
Bên trong một GPU server có gì
The workhorse of an AI data center is the GPU server: a machine built around several GPUs wired tightly together. NVIDIA’s HGX boards are a common example, with eight GPUs on one board, built into servers by many makers and by NVIDIA itself, whose own version is called DGX. The table compares four of these boards, from three generations of GPU. The figures come from NVIDIA’s own product pages and datasheets.3.1, 3.2, 3.3, 3.4 One scale helps in reading them: a terabyte a second (TB/s) is a thousand gigabytes a second, and a full-length HD film is a few gigabytes, so 8 TB/s would move very roughly two thousand films every second.
Cỗ máy chủ lực trong một data center dành cho AI là GPU server: loại máy chủ gắn nhiều GPU được nối chặt với nhau. Bo mạch HGX của NVIDIA là một ví dụ phổ biến, với tám GPU trên cùng một bo, được nhiều hãng lắp vào máy chủ của mình, kể cả chính NVIDIA với dòng máy mang tên DGX. Bảng dưới đây so sánh bốn bo mạch như vậy, thuộc ba thế hệ GPU, theo số liệu từ trang sản phẩm và tài liệu kỹ thuật của NVIDIA.3.1, 3.2, 3.3, 3.4 Để dễ hình dung các con số: một terabyte mỗi giây (TB/s) là một nghìn gigabyte mỗi giây, mà một bộ phim HD dài chỉ nặng vài gigabyte, nên 8 TB/s đủ để chuyển đại khái hai nghìn bộ phim mỗi giây.
| HGX A100 | HGX H100 | HGX H200 | HGX B200 | |
|---|---|---|---|---|
| GPUs | 8 × A100 80 GB (Ampere) | 8 × H100 (Hopper) | 8 × H200 (Hopper) | 8 × B200 (Blackwell) |
| Total GPU memory | 640 GB | 640 GB | 1,128 GB (about 1.1 TB) | 1,440 GB (about 1.4 TB) |
| Memory bandwidth, per GPU | 2 TB/s | 3.35 TB/s | 4.8 TB/s | 8 TB/s |
| GPU-to-GPU link (NVLink), per GPU | 600 GB/s | 900 GB/s | 900 GB/s | 1.8 TB/s |
| Total NVLink bandwidth | 4.8 TB/s | 7.2 TB/s | 7.2 TB/s | 14.4 TB/s |
| HGX A100 | HGX H100 | HGX H200 | HGX B200 | |
|---|---|---|---|---|
| GPU | 8 × A100 80 GB (Ampere) | 8 × H100 (Hopper) | 8 × H200 (Hopper) | 8 × B200 (Blackwell) |
| Tổng bộ nhớ GPU | 640 GB | 640 GB | 1.128 GB (khoảng 1,1 TB) | 1.440 GB (khoảng 1,4 TB) |
| Băng thông bộ nhớ, mỗi GPU | 2 TB/s | 3,35 TB/s | 4,8 TB/s | 8 TB/s |
| Kết nối giữa các GPU (NVLink), mỗi GPU | 600 GB/s | 900 GB/s | 900 GB/s | 1,8 TB/s |
| Tổng băng thông NVLink | 4,8 TB/s | 7,2 TB/s | 7,2 TB/s | 14,4 TB/s |
Two rows matter as much as raw speed. Memory holds the model and its data, and for much of AI work a GPU can compute only as fast as memory can feed it, so memory bandwidth, the amount of data it can move each second, has had to climb with each generation, from 2 to 8 terabytes a second per GPU. The NVLink rows measure how fast the eight GPUs can pass data among themselves, which matters because a large model is often split across them and they must constantly exchange results. All of this takes power: NVIDIA lists a DGX B200 system, built on the same eight Blackwell GPUs, at about 14.3 kilowatts at full load, roughly what ten electric kettles draw while they all boil at once.3.3
Có hai hàng quan trọng không kém tốc độ tính toán. Bộ nhớ chứa mô hình và dữ liệu, mà với nhiều loại công việc AI, GPU chỉ tính nhanh được bằng tốc độ bộ nhớ cấp dữ liệu cho nó. Vì vậy băng thông bộ nhớ, tức lượng dữ liệu truyền được mỗi giây, đã phải tăng lên qua từng thế hệ, từ 2 lên 8 terabyte mỗi giây cho mỗi GPU. Các hàng NVLink đo tốc độ tám GPU trao đổi dữ liệu với nhau. Điều này quan trọng vì một mô hình lớn thường được chia ra cho các GPU ấy, và chúng phải liên tục chuyển kết quả qua lại. Tất cả những thứ ấy đều ngốn điện: theo NVIDIA, một hệ thống DGX B200, dùng đúng tám GPU Blackwell ấy, tiêu thụ khoảng 14,3 kilowatt khi chạy hết công suất, xấp xỉ mười chiếc ấm đun nước siêu tốc cùng đun một lúc.3.3
Why the whole industry heats up
Vì sao cả ngành bán dẫn cùng nóng lên
Look inside the server and specialised chips are everywhere, well beyond the GPUs. Memory modules and storage drives carry their own controller chips, and so do network cards and switches. The speed at which memory loads data has to be matched to the speed of the processors it feeds, or the fastest processor simply waits.
Nhìn vào bên trong máy chủ sẽ thấy chip chuyên dụng có mặt ở khắp nơi, bên cạnh GPU. Mô-đun bộ nhớ và ổ lưu trữ đều có chip điều khiển riêng, card mạng và bộ chuyển mạch cũng vậy. Tốc độ bộ nhớ nạp dữ liệu phải tương xứng với tốc độ của bộ xử lý mà nó cấp dữ liệu, nếu không, bộ xử lý nhanh nhất cũng chỉ ngồi chờ.
The memory on an AI GPU shows how far that matching has gone. It is high-bandwidth memory, or HBM: DRAM chips stacked like the floors of a small tower, set right beside the GPU in the same package.3.5 That short, very wide path is how a single GPU reaches the memory bandwidth in the table above, and it is one reason memory makers have a large part in the AI story.
Bộ nhớ trên một GPU AI cho thấy sự tương xứng ấy đã được đẩy xa đến đâu. Đó là bộ nhớ băng thông cao (high-bandwidth memory, HBM): những chip DRAM xếp chồng lên nhau như các tầng của một tòa tháp nhỏ, đặt ngay sát GPU trong cùng một package (phần đóng gói của chip).3.5 Đường đi ngắn mà rất rộng ấy giúp một GPU đạt băng thông bộ nhớ như trong bảng ở trên, và cũng là một lý do khiến các hãng làm bộ nhớ có vai trò lớn trong câu chuyện AI.
So a data center is less a pile of machines than an ecosystem, in which every component matters. That is why, as AI spread, the whole semiconductor industry heated up: NVIDIA, and with it memory makers, networking companies and every other hardware firm whose parts end up in those buildings.
Vì thế, một data center không đơn thuần là một đống máy móc mà là cả một hệ sinh thái, trong đó thành phần nào cũng quan trọng. Đó là lý do khi AI lan rộng, toàn ngành bán dẫn cùng nóng lên: NVIDIA, và cùng với NVIDIA là các hãng làm bộ nhớ, các công ty thiết bị mạng và mọi hãng phần cứng khác có linh kiện nằm trong những tòa nhà ấy.
Many applications can share one GPU
Nhiều ứng dụng có thể dùng chung một GPU
Hardware is only half the picture. A data center also needs software to manage all that hardware well, and this is where chips and software meet. Chapter 2 showed that training a large model can cost tens to hundreds of millions of dollars in computing alone, and runs of that size keep whole GPUs busy. The waste is elsewhere: in many data centers, a GPU given to one smaller job, such as serving a modest model or running a developer’s tests, is often not kept fully busy.
Phần cứng mới chỉ là một nửa bức tranh. Một data center còn cần phần mềm để quản lý toàn bộ phần cứng ấy cho hiệu quả, và đây là chỗ chip và phần mềm giao nhau. Chương 2 đã cho thấy riêng chi phí tính toán để training một mô hình lớn có thể lên tới hàng chục, thậm chí hàng trăm triệu đô la, và những đợt training cỡ đó dùng trọn công suất GPU. Chỗ lãng phí nằm ở nơi khác: ở nhiều data center, một GPU giao cho một việc nhỏ hơn, như phục vụ một mô hình vừa phải hay chạy thử của lập trình viên, thường không chạy hết công suất.
GPU virtualization is one answer. It lets several applications share one physical GPU, so each GPU does more useful work and the cost of infrastructure and its management comes down. There are several ways to do it.
Ảo hóa GPU (GPU virtualization) là một lời giải. Kỹ thuật này cho phép nhiều ứng dụng dùng chung một GPU vật lý, nhờ đó mỗi GPU làm được nhiều việc có ích hơn, còn chi phí hạ tầng và chi phí quản lý giảm xuống. Có nhiều cách để ảo hóa GPU.
- At the application layer. A virtual version of the CUDA library sits between applications and the GPU, so several applications can share one GPU’s processing at the same time instead of taking turns owning it.
- At the driver layer. The GPU’s own driver software divides the physical GPU into parts, for example by giving each virtual GPU a fixed share of its memory. Each part appears as a separate virtual GPU, and a virtual machine can use one or more of them.3.6
- By sharing time. The virtual machines take turns on the GPU’s compute time, so while one application runs, others can still use the same GPU.3.6
- Ở tầng ứng dụng. Một phiên bản ảo của thư viện CUDA nằm giữa các ứng dụng và GPU, cho phép nhiều ứng dụng cùng lúc dùng chung khả năng xử lý của một GPU thay vì lần lượt chiếm trọn nó.
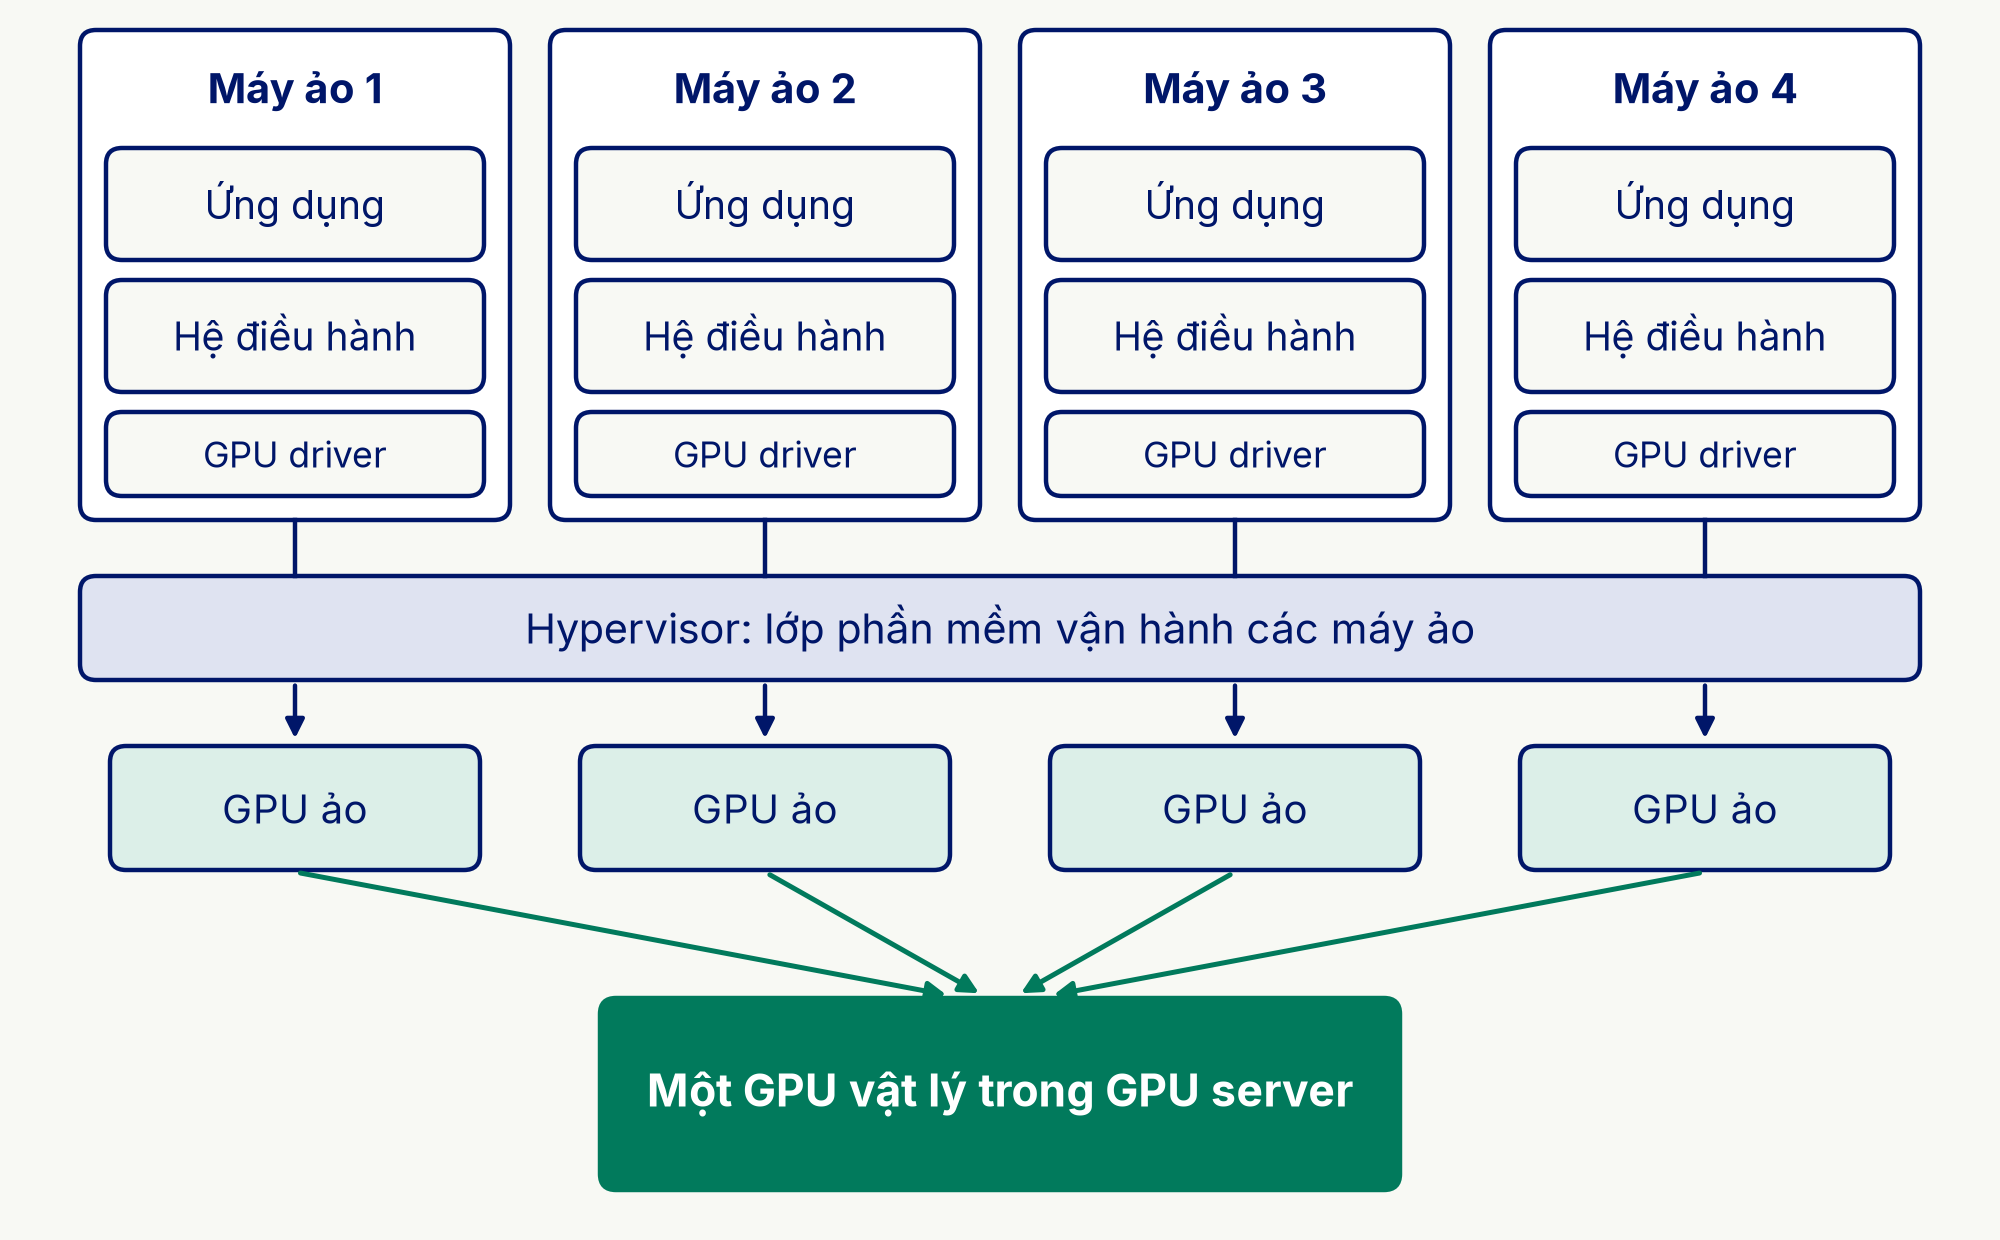
- Ở tầng trình điều khiển (driver). Chính phần mềm điều khiển GPU chia GPU vật lý thành nhiều phần, chẳng hạn cấp cho mỗi GPU ảo một phần bộ nhớ cố định. Mỗi phần hiện ra như một GPU ảo riêng, và một máy ảo (virtual machine) có thể dùng một hoặc nhiều GPU ảo như thế.3.6
- Chia sẻ thời gian. Các máy ảo lần lượt dùng thời gian tính toán của GPU, nhờ đó khi một ứng dụng đang chạy, các ứng dụng khác vẫn dùng được chính GPU ấy.3.6
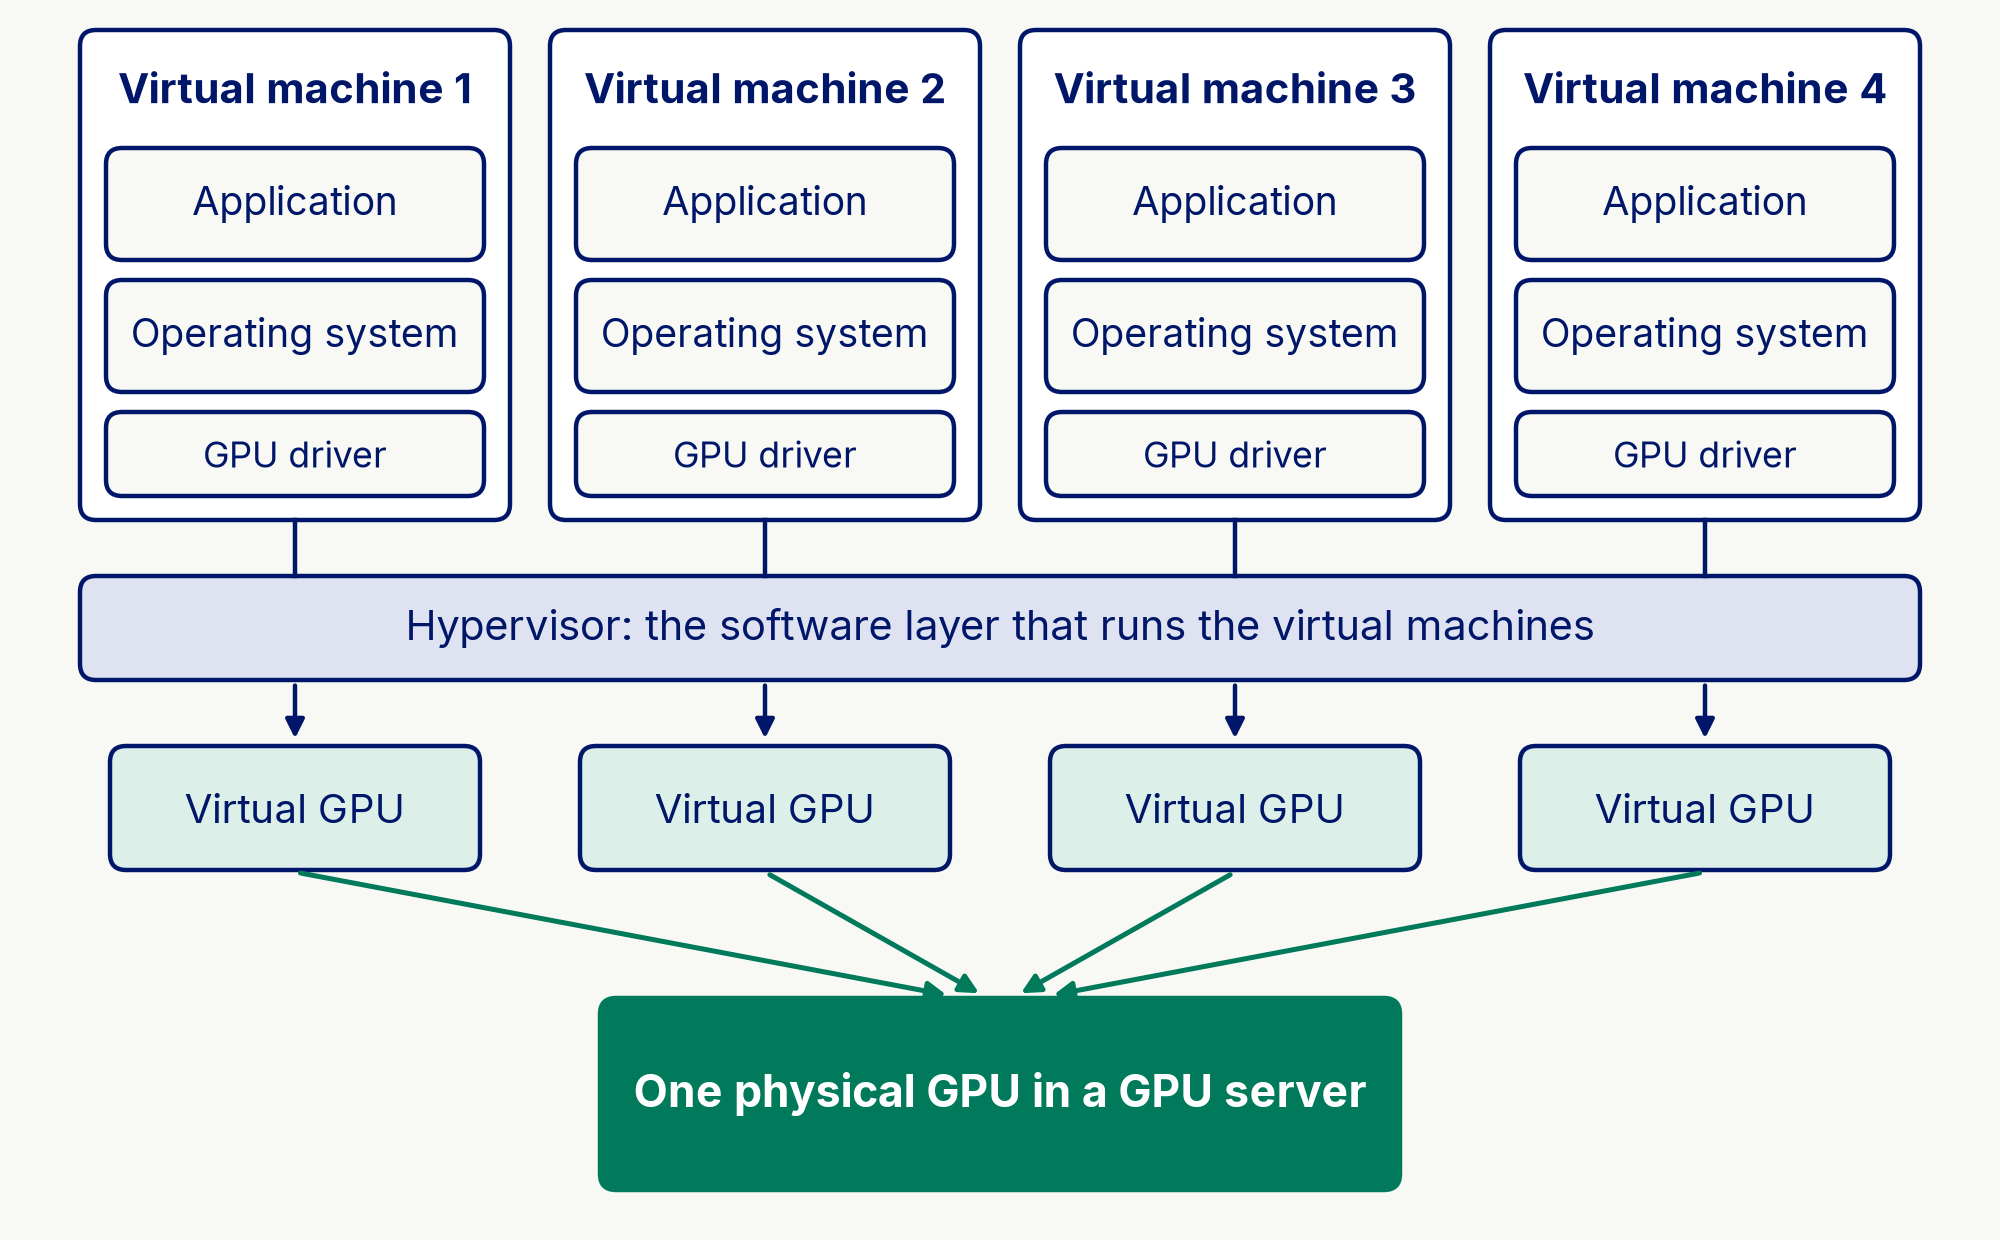
The plate shows the driver approach in its usual setting. A hypervisor, the software layer that creates and runs virtual machines, sits between them and the hardware, and each virtual machine sees what looks like its own GPU. NVIDIA’s recent data-center GPUs can also be split in hardware: its Multi-Instance GPU feature divides one GPU into as many as seven isolated instances, each with its own memory, cache and compute cores.3.7
Hình trên minh họa cách làm ở tầng driver trong bối cảnh thường gặp. Một hypervisor, tức lớp phần mềm tạo ra và vận hành các máy ảo, nằm giữa chúng và phần cứng, và máy ảo nào cũng tưởng như mình có một GPU riêng. Với các GPU data center gần đây, NVIDIA còn chia được ngay ở mức phần cứng. Tính năng Multi-Instance GPU chia một GPU thành tối đa bảy phần độc lập, mỗi phần có bộ nhớ, cache và lõi tính toán riêng.3.7
It is easy to picture a data center as a building where as many GPUs as can be bought are plugged in and switched on. Plugged in, they will run. Making them run as one system, efficiently and at a cost that makes AI worth running, takes software as well as silicon. The next chapter opens up one of those chips.
Rất dễ hình dung data center như một tòa nhà, nơi người ta cắm vào bao nhiêu GPU mua được rồi bật lên. Cắm vào thì máy vẫn chạy. Nhưng để chúng vận hành như một hệ thống, hiệu quả và với chi phí đủ thấp để việc chạy AI trở nên đáng giá, thì cần cả phần mềm lẫn silicon. Chương tiếp theo sẽ mở một trong những con chip ấy ra.