Chapter 2 of 9Chương 2/9 5 min5 phút
Why AI took off nowVì sao AI bùng nổ lúc này
AI began long before ChatGPT. Neural networks were being built decades earlier, and for most of that time their answers were too often wrong to trust. What changed was not one clever idea but three things arriving at once.
AI đã có từ rất lâu trước ChatGPT. Neural network (mạng nơ-ron) đã được xây dựng từ nhiều thập kỷ trước, và suốt phần lớn thời gian ấy, kết quả của chúng vẫn sai thường xuyên đến mức chẳng ai dám tin dùng. Điều thay đổi không phải một ý tưởng thông minh đơn lẻ, mà là ba yếu tố cùng lúc hội tụ.
In this chapter
Trong chương này
- Why AI existed for decades before most people noticed it
- The three ingredients that had to arrive together: large models, huge training data and fast chips
- Why a neural-network design from around 1989 waited about twenty years for the right hardware
- How large language models made AI something anyone can talk to
- How large today’s models are, and what the computing to train one costs
- Vì sao AI đã tồn tại hàng chục năm trước khi phần đông mọi người nhận ra
- Ba yếu tố phải cùng hội tụ: mô hình lớn, dữ liệu training khổng lồ và chip tính toán nhanh
- Vì sao một thiết kế neural network từ khoảng năm 1989 phải chờ chừng hai mươi năm mới gặp được phần cứng phù hợp
- Mô hình ngôn ngữ lớn giúp ai cũng trò chuyện được với AI như thế nào
- Các mô hình ngày nay lớn đến đâu, và riêng phần tính toán để training một mô hình tốn bao nhiêu
AI is older than it looks
AI không mới như ta tưởng
Artificial intelligence feels new, but working applications existed well before the 2010s. In the early 2000s, programs already recognised images with a neural network, and expert systems gave sales advice by following long lists of rules written by people. Most people never noticed them. Their answers were not accurate enough to lean on, and talking to them took specialist skill.
AI nghe có vẻ mới, nhưng các ứng dụng AI chạy được đã có từ trước thập niên 2010. Đầu những năm 2000, đã có những chương trình nhận dạng hình ảnh bằng neural network, hay những expert system (hệ chuyên gia) đưa ra tư vấn bán hàng dựa trên hàng loạt quy tắc do con người viết sẵn. Phần đông mọi người không hề biết đến chúng. Câu trả lời của chúng chưa đủ chính xác để dựa vào, còn muốn tương tác với chúng thì phải có chuyên môn.
A big bottleneck was computing power. A neural network learns by training: it is shown example after example and adjusts itself a little each time until its answers improve. On the hardware of the day, training a model could take many days, and often it still did not reach the accuracy that was needed.
Một nút thắt lớn nằm ở sức mạnh tính toán. Một neural network học bằng cách training (huấn luyện): người ta cho nó xem hết ví dụ này đến ví dụ khác, và sau mỗi lần nó lại tự điều chỉnh một chút, cho đến khi câu trả lời tốt dần lên. Với phần cứng thời đó, training một mô hình có thể mất nhiều ngày, mà nhiều khi vẫn chưa đạt độ chính xác mong muốn.
Accuracy decides whether a model can be used at all. Imagine a self-driving car whose model is right 80 percent of the time. Few people would climb in and let it drive. Only when accuracy became high enough to rely on did applications that had been impossible become real, and that is when AI stopped being a lab curiosity.
Độ chính xác quyết định một mô hình có dùng được hay không. Hãy hình dung một chiếc xe tự lái có mô hình chỉ chính xác 80%. Sẽ chẳng mấy ai dám bước lên để nó cầm lái. Chỉ khi độ chính xác đủ cao để người ta có thể dựa vào, những ứng dụng trước kia không thể làm nổi mới thành hiện thực, và từ đó AI không còn chỉ quanh quẩn trong phòng thí nghiệm.
Accuracy jumped once three ingredients came together
Độ chính xác tăng vọt khi ba yếu tố cùng hội tụ
The turn came with the rise of deep learning around 2010 to 2012: neural networks with many layers, trained on large amounts of data. Deep learning is one branch of machine learning, the wider field of programs that learn from data rather than from rules someone wrote down. Its accuracy jumped once three ingredients were in place together: models large and powerful enough, huge amounts of data to train them on, and chips fast enough to do the training in reasonable time.
Bước ngoặt đến cùng sự trỗi dậy của học sâu (deep learning) vào khoảng năm 2010 đến 2012: những neural network nhiều lớp, học từ lượng dữ liệu lớn. Deep learning là một nhánh của machine learning, lĩnh vực rộng hơn gồm các chương trình học từ dữ liệu thay vì từ những quy tắc do người viết ra. Độ chính xác của deep learning tăng vọt khi ba yếu tố cùng có mặt: mô hình đủ lớn và đủ mạnh, dữ liệu khổng lồ để training, và chip đủ nhanh để việc training xong trong thời gian chấp nhận được.
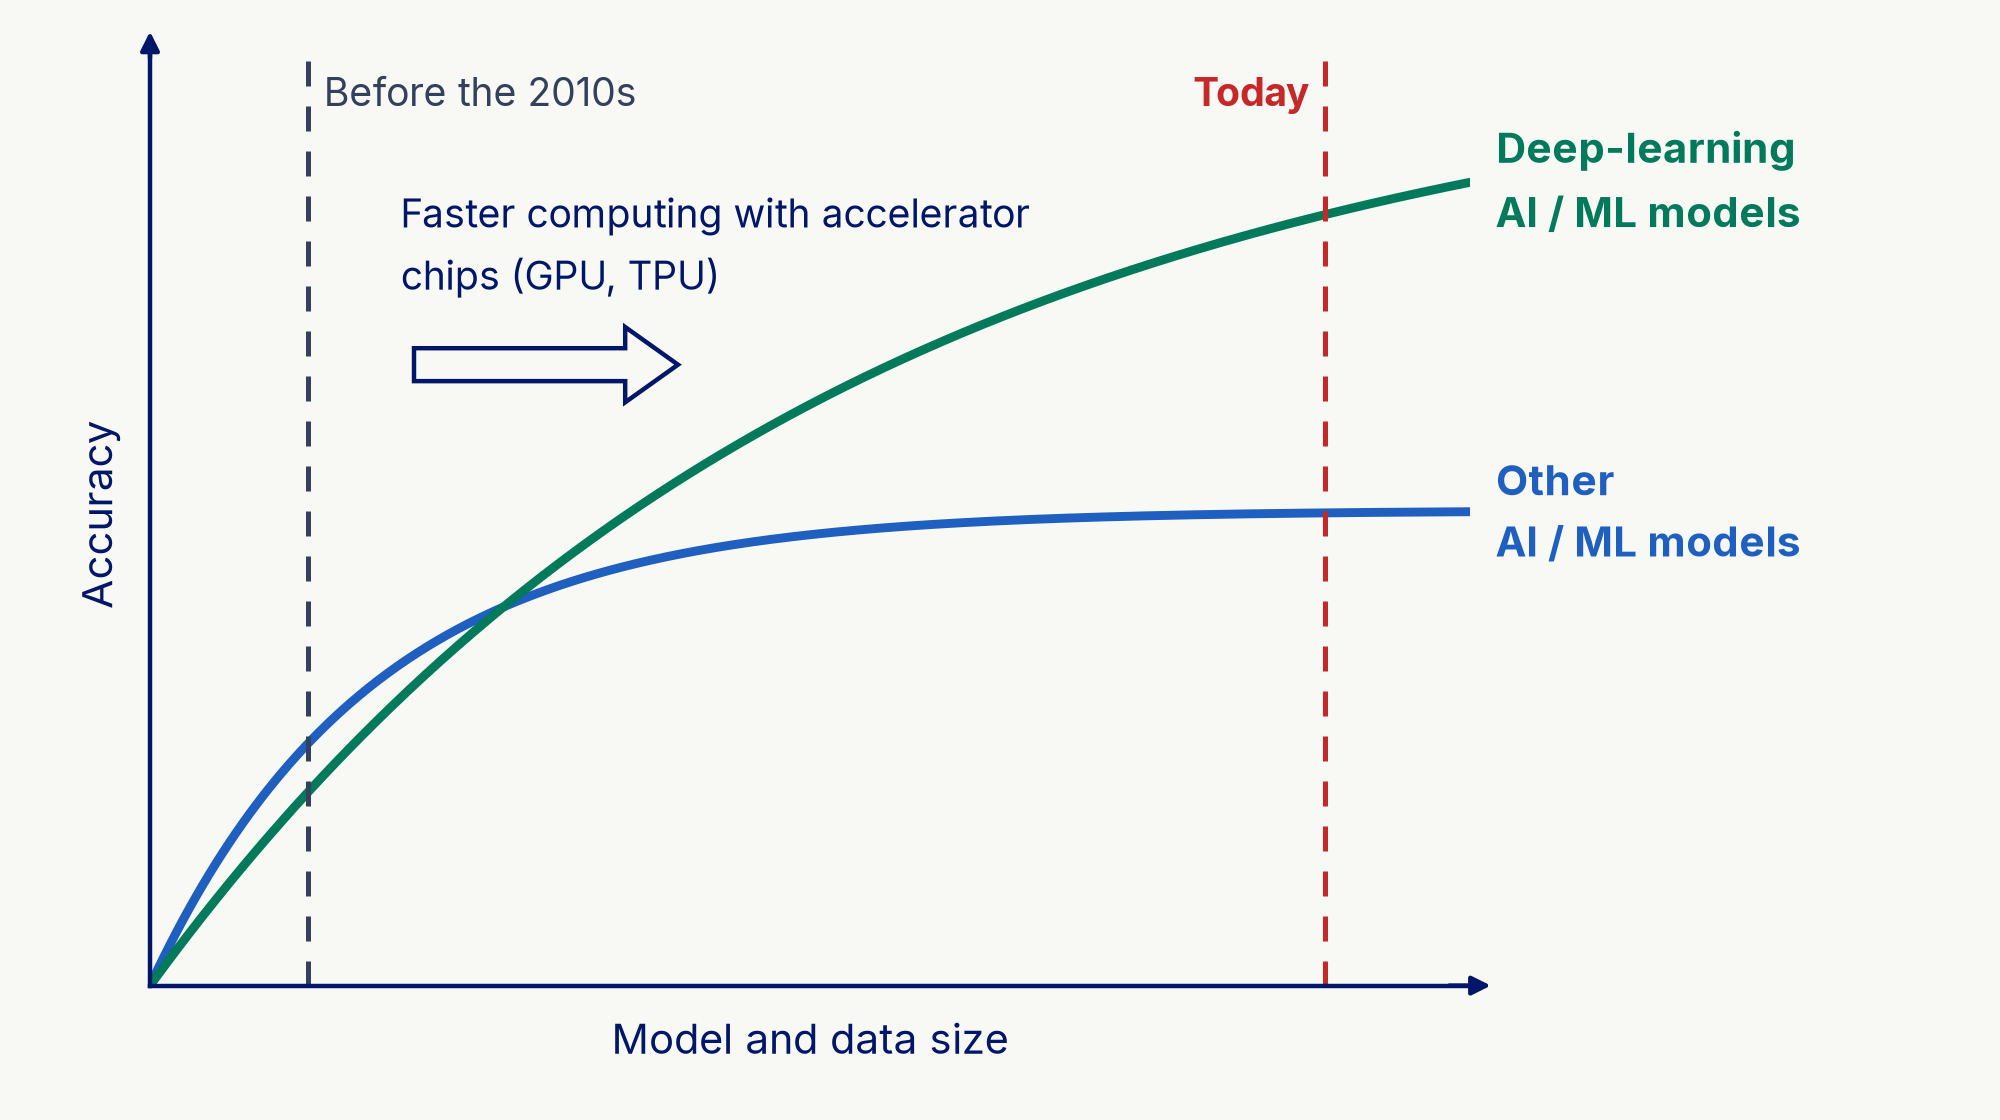
The plate below shows why the timing mattered. Older methods improve quickly on small models and small datasets, then level off. Deep learning starts behind them but keeps improving as models and data grow. Before the 2010s, the world sat on the left of this chart, where the older methods still looked better. GPUs, and later accelerator chips such as the TPU, pushed it far to the right.
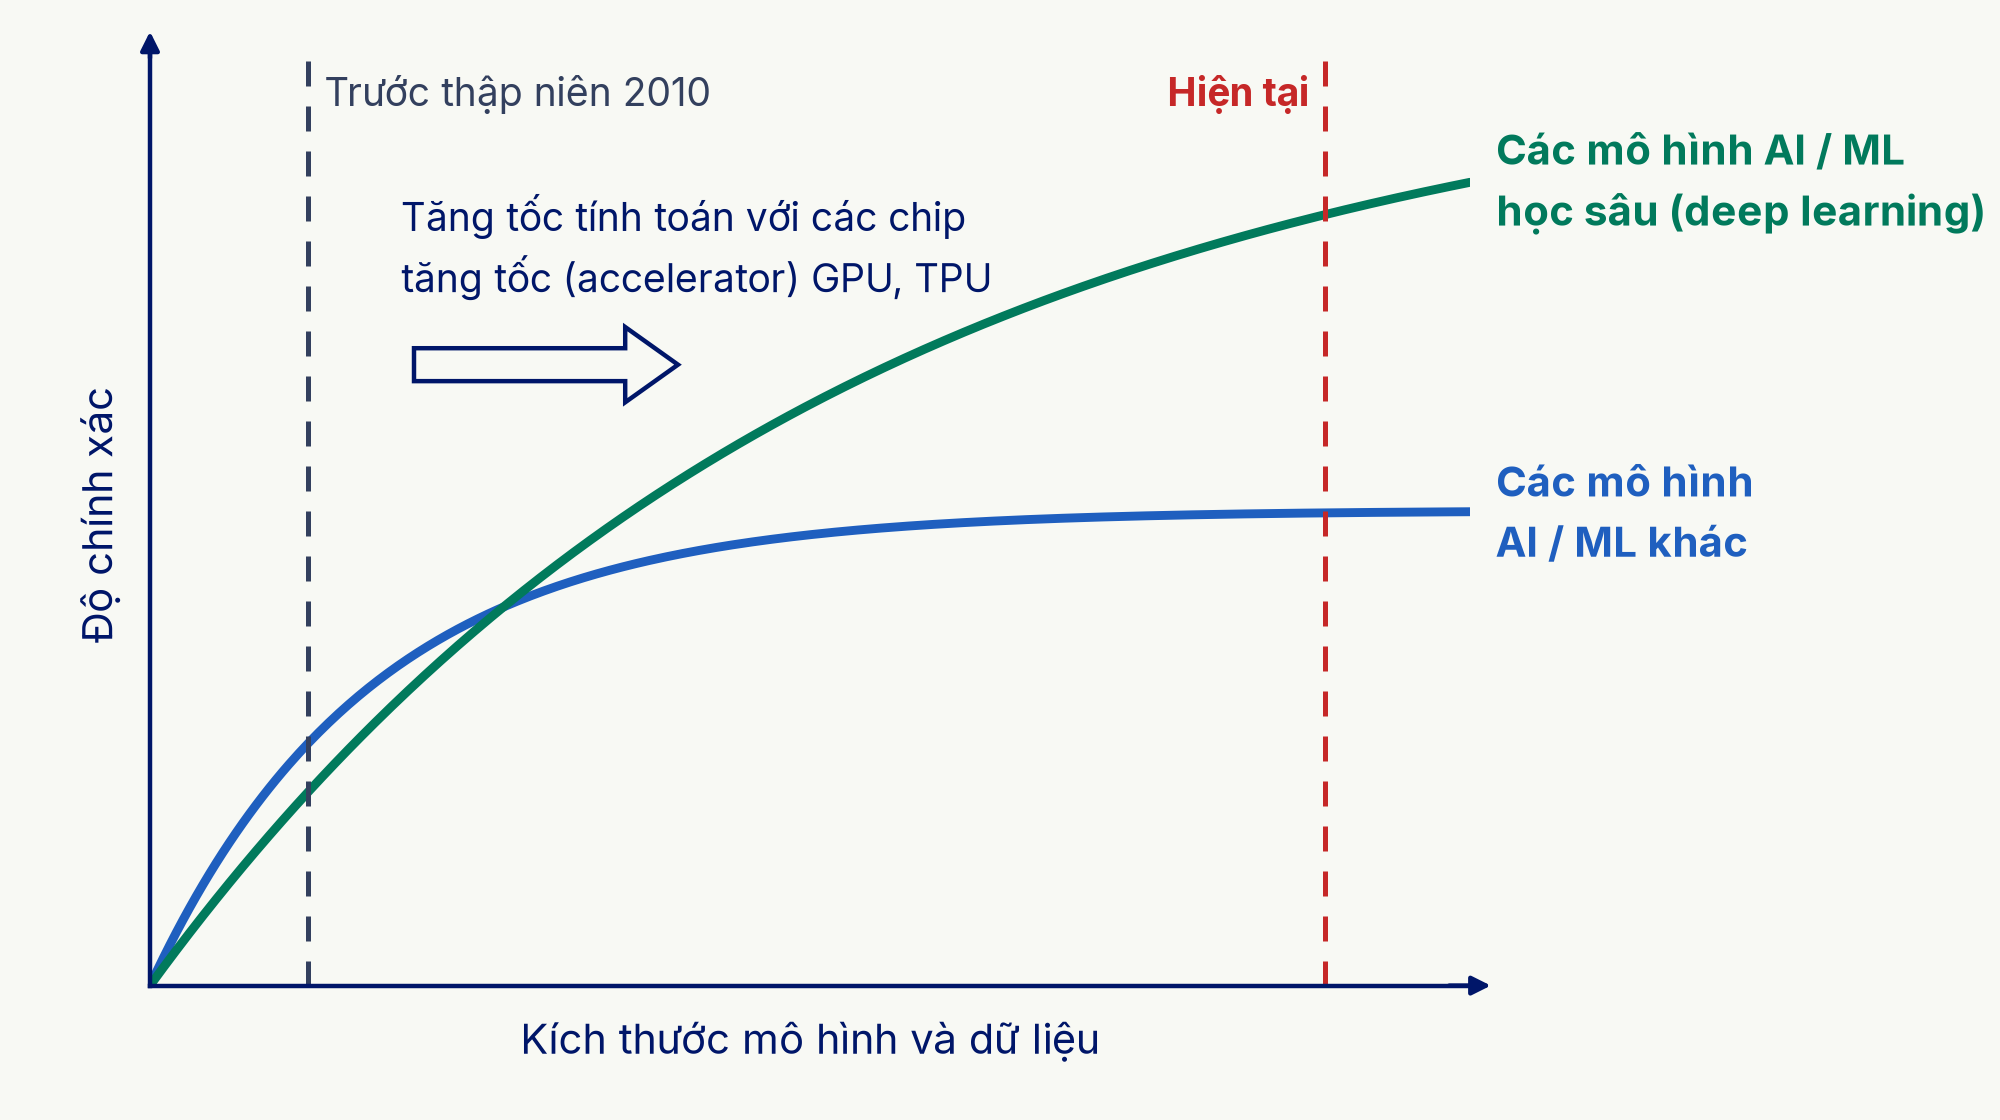
Hình dưới đây cho thấy vì sao thời điểm lại quan trọng đến thế. Các phương pháp cũ tiến bộ nhanh khi mô hình và tập dữ liệu còn nhỏ, rồi chững lại. Deep learning xuất phát thấp hơn nhưng vẫn tiếp tục tốt lên khi mô hình và dữ liệu lớn dần. Trước thập niên 2010, thế giới còn đứng ở phía trái biểu đồ, nơi các phương pháp cũ trông vẫn tốt hơn. Chính GPU, và về sau là các accelerator (chip tăng tốc) như TPU (Tensor Processing Unit), đã đẩy thế giới sang hẳn phía phải.
The field that supplies the third ingredient is high performance computing: hardware and software built to run enormous numbers of calculations quickly, often with many processors working on one problem. It is what turned large models and large datasets into accurate results. Without it, the other two ingredients would have sat idle.
Lĩnh vực cung cấp yếu tố thứ ba là tính toán hiệu năng cao (High Performance Computing, HPC): phần cứng và phần mềm chuyên dùng để chạy thật nhanh một khối lượng phép tính khổng lồ, thường với nhiều bộ xử lý cùng giải một bài toán. Chính nó đã biến mô hình lớn và dữ liệu lớn thành kết quả chính xác. Thiếu nó, hai yếu tố còn lại cũng không phát huy được tác dụng.
A neural network slept for about twenty years, waiting for the right chip
Một neural network đã “ngủ” khoảng hai mươi năm, chờ con chip phù hợp
The network that slept was a convolutional neural network, or CNN. It is a deep-learning design that looks at an image through small windows and builds up from edges to shapes to objects. Yann LeCun and his colleagues at Bell Labs published one in 1989, trained to read handwritten postal codes.2.1 The idea was sound, and by the late 1990s a version of it was reading handwritten cheques for American banks, yet for about twenty years it stayed a specialist tool.2.2
Neural network đã “ngủ” ấy thuộc loại Convolutional Neural Network (CNN). Đây là một thiết kế deep learning nhìn bức ảnh qua từng “ô cửa” nhỏ, rồi ghép dần từ các đường nét thành hình khối, từ hình khối thành vật thể. Năm 1989, Yann LeCun và các cộng sự ở Bell Labs công bố một mạng CNN học cách đọc mã bưu chính viết tay.2.1 Ý tưởng thì đúng, và đến cuối thập niên 1990 một phiên bản của nó đã đọc séc viết tay cho các ngân hàng Mỹ, vậy mà suốt khoảng hai mươi năm sau, nó vẫn chỉ là công cụ của giới chuyên môn.2.2
It woke up in 2012. A CNN called AlexNet, trained on two NVIDIA gaming graphics cards over five to six days, won the ImageNet image-recognition competition by a wide margin.2.3 The basic design was close to the one from 1989. What had changed was everything around it: a far larger collection of labelled images to learn from, a few new training techniques, and chips fast enough to train a much bigger network. The story is like the sleeping beauty of the old tale, who sleeps for a hundred years until the prince arrives. Here the wait was about twenty, and the prince is the GPU, or an accelerator like it.
Nó “thức giấc” vào năm 2012. Một mạng CNN tên AlexNet, được training trong năm đến sáu ngày trên hai card đồ họa chơi game của NVIDIA, đã thắng cuộc thi nhận dạng hình ảnh ImageNet với khoảng cách rất xa.2.3 Thiết kế cơ bản vẫn gần giống năm 1989. Thứ thay đổi là mọi thứ xung quanh nó: một kho ảnh gắn nhãn lớn hơn nhiều để học, vài kỹ thuật training mới, và những con chip đủ nhanh để training một mạng lớn hơn hẳn. Chuyện này giống truyện cổ về nàng công chúa ngủ trong rừng: nàng ngủ suốt trăm năm cho tới khi hoàng tử xuất hiện. Ở đây, giấc ngủ kéo dài khoảng hai mươi năm, và hoàng tử chính là GPU, hoặc một chip accelerator tương tự.
Two names in that story need a word now, because they come back in every chapter that follows. A GPU is a processor built to run a great many simple calculations in parallel, first to draw the pixels of video games. CUDA, which NVIDIA introduced in late 2006, is the software platform that let programmers use those processors for general computation, not only graphics.2.4 Chapter 4 explains how a GPU differs from a CPU, and chapter 5 why that difference suits AI so well, including the CUDA story.
Có hai cái tên trong câu chuyện này cần nói rõ ngay, vì chúng sẽ trở lại ở mọi chương sau. GPU (Graphics Processing Unit) là loại bộ xử lý sinh ra để chạy song song rất nhiều phép tính đơn giản, ban đầu là để vẽ từng điểm ảnh trong trò chơi điện tử. CUDA, nền tảng phần mềm NVIDIA giới thiệu vào cuối năm 2006, cho phép lập trình viên dùng các bộ xử lý ấy để tính toán đa dụng, không riêng gì đồ họa.2.4 Chương 4 giải thích GPU khác CPU ở điểm nào, còn chương 5 lý giải vì sao khác biệt ấy lại hợp với AI đến vậy, trong đó có câu chuyện về CUDA.
Large language models let anyone talk to AI
Mô hình ngôn ngữ lớn giúp ai cũng trò chuyện được với AI
Accuracy explains why AI started to work. The sudden rush of people using it had a second cause, the large language model, or LLM, a model trained on enormous amounts of text to predict and produce language. When OpenAI released ChatGPT on 30 November 2022, anyone could type a question in plain words and get a fluent answer back.2.5
Độ chính xác cho thấy vì sao AI bắt đầu dùng được. Còn việc bỗng dưng ai cũng dùng AI lại có một nguyên nhân thứ hai: mô hình ngôn ngữ lớn (Large Language Model, LLM), loại mô hình học từ lượng văn bản khổng lồ để dự đoán và tạo ra ngôn ngữ. Khi OpenAI phát hành ChatGPT ngày 30/11/2022, bất kỳ ai cũng có thể gõ một câu hỏi bằng lời thường và nhận lại câu trả lời trôi chảy.2.5
That friendliness mattered as much as the technology. People who had never thought about AI could see its uses for themselves, as if a door had opened onto a long corridor of possible applications, and they began to try it in their own work. The boom of the last few years comes from both reasons together: models accurate enough to trust, and an interface anyone can use.
Sự thân thiện ấy quan trọng không kém bản thân công nghệ. Những người chưa từng nghĩ đến AI giờ tự mình thấy được nó dùng vào việc gì, như thể một cánh cửa vừa mở ra, dẫn tới vô số ứng dụng. Từ đó, họ bắt đầu thử nó trong công việc của mình. Cơn bùng nổ vài năm gần đây đến từ cả hai lý do cùng lúc: mô hình đủ chính xác để tin dùng, và một giao diện ai cũng dùng được.
Bigger models, bigger bills
Mô hình càng lớn, chi phí càng cao
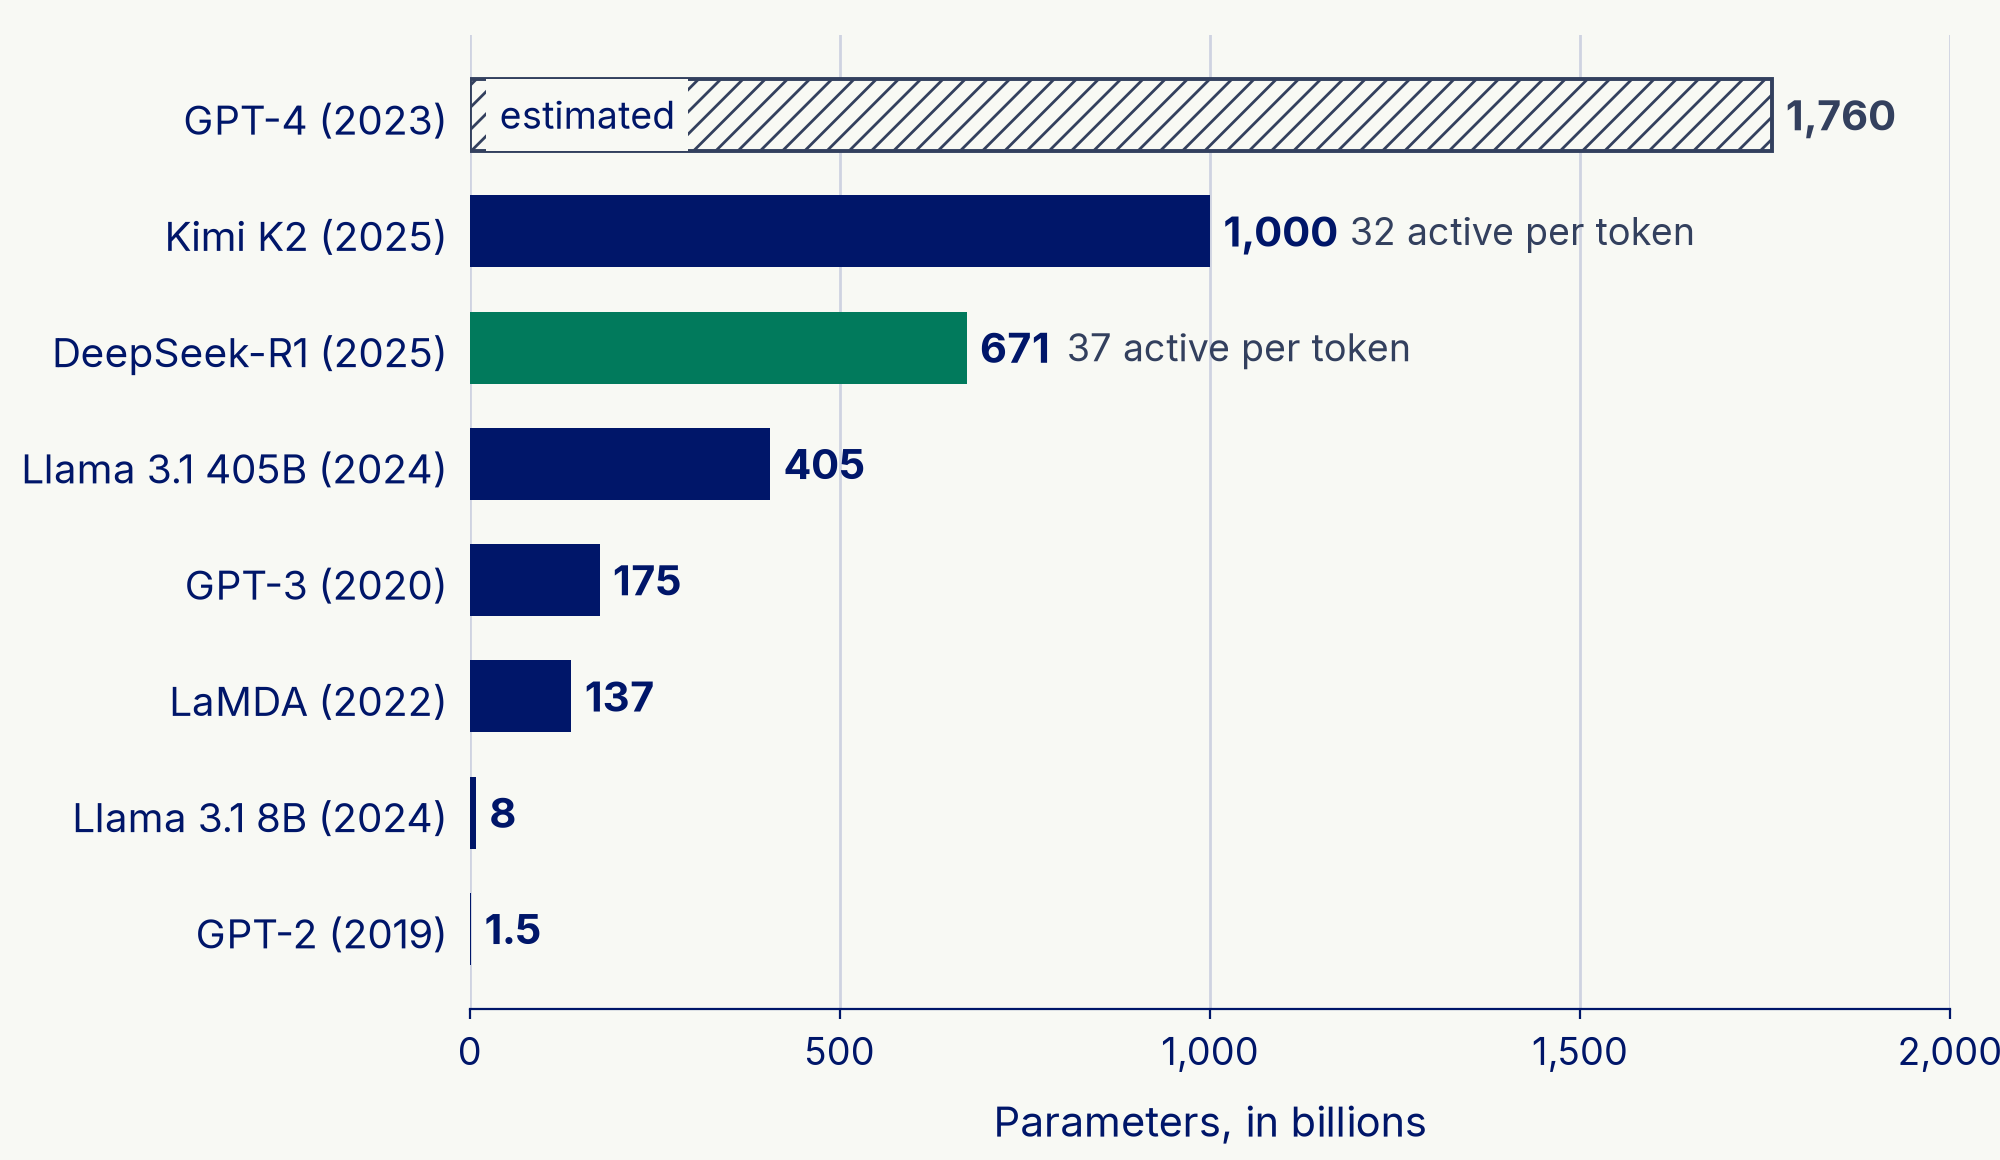
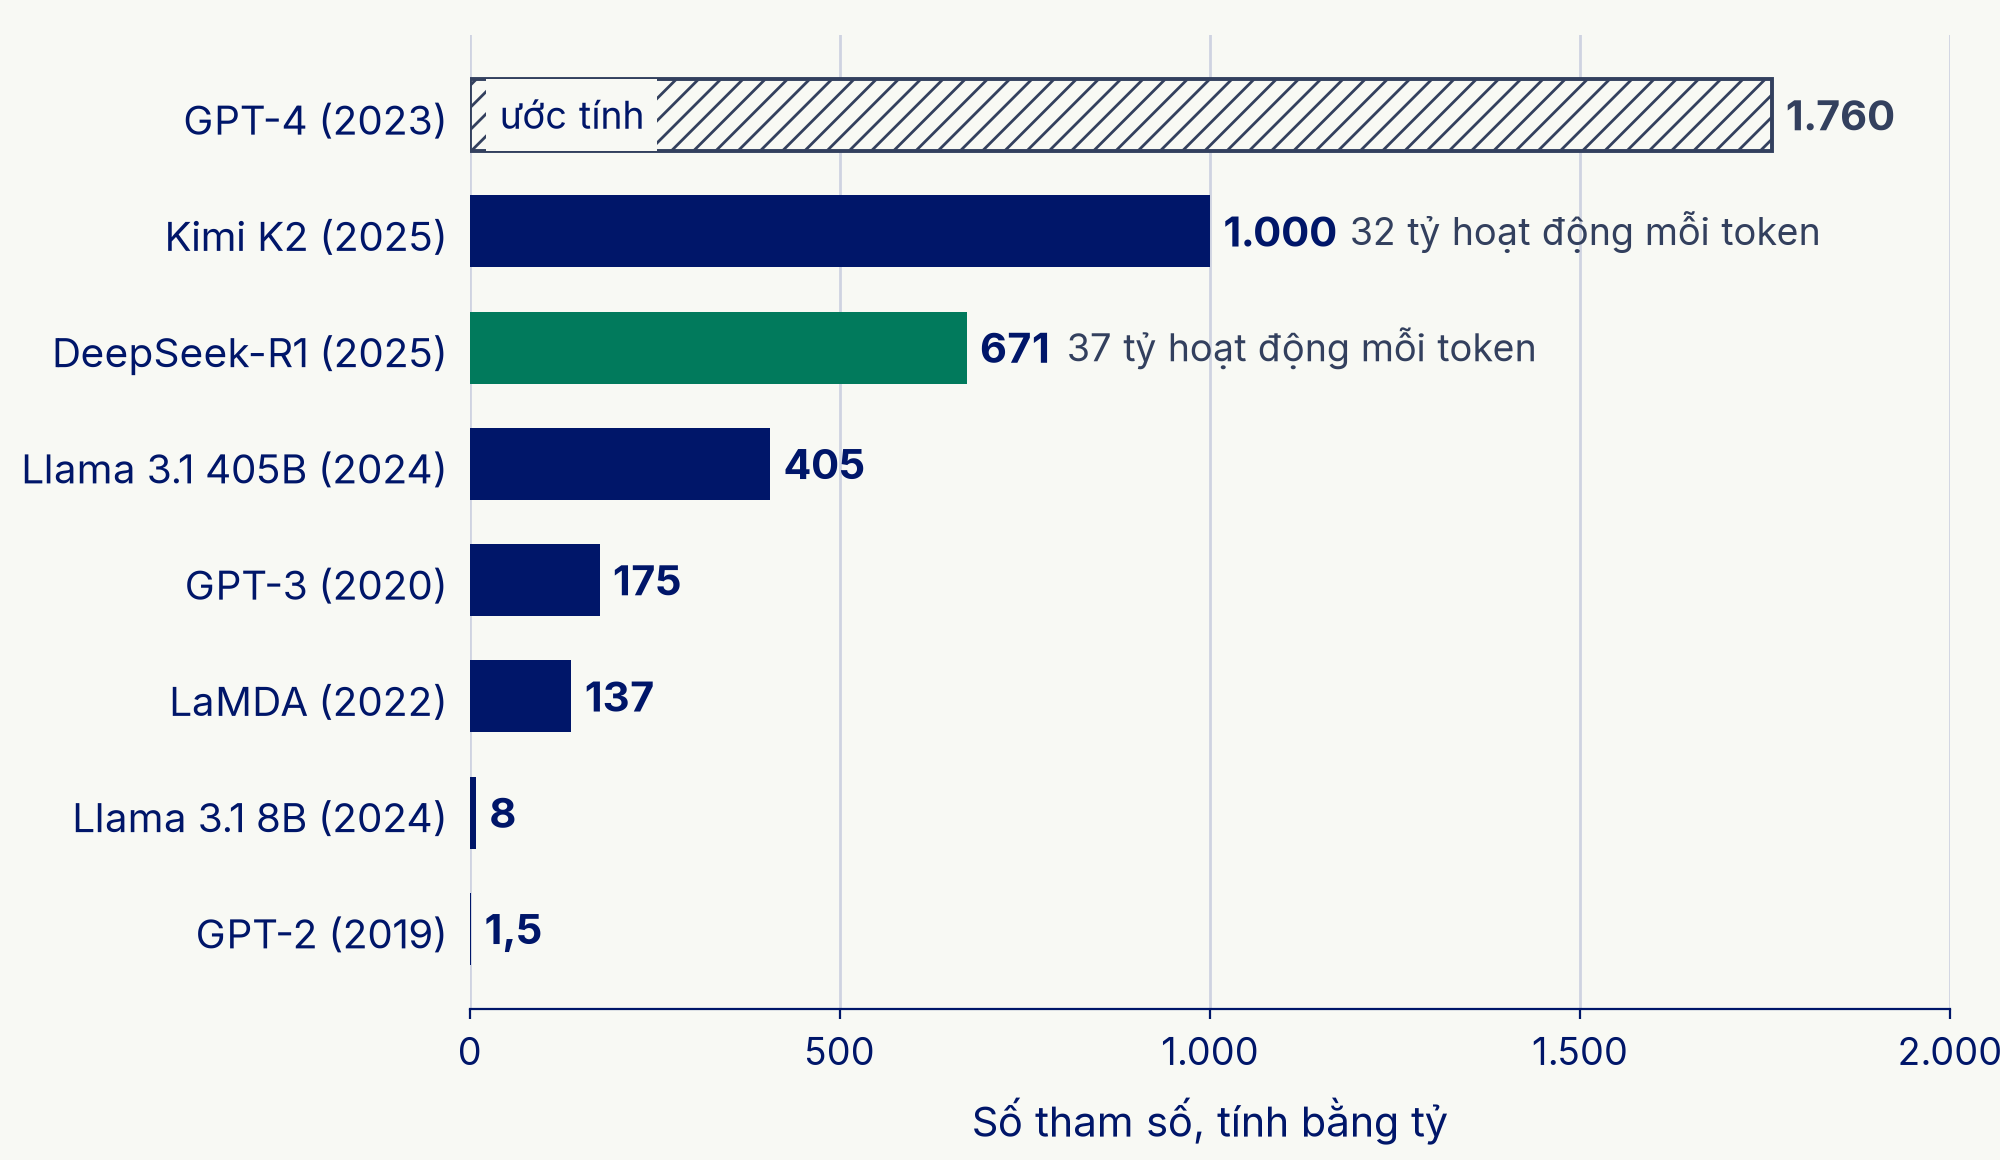
Large language models earn their name. A model’s size is counted in parameters, the internal numbers it adjusts during training, and today’s large models have hundreds of billions of them, and one published model reaches a trillion. The plate below shows the sizes their makers have published.2.6, 2.7 GPT-4’s bar is hatched because OpenAI has never disclosed its size: the 1,760 billion shown is an estimate that leaked in 2023, not a published figure.2.8
Mô hình ngôn ngữ lớn quả thật lớn đúng như tên gọi. Kích thước mô hình tính bằng số tham số, tức những con số nội tại mà mô hình tự điều chỉnh trong quá trình training, và các mô hình lớn ngày nay có tới hàng trăm tỷ tham số. Một mô hình đã công bố còn lên tới một nghìn tỷ. Hình dưới đây cho thấy kích thước các mô hình theo số liệu nhà phát triển đã công bố.2.6, 2.7 Cột của GPT-4 được tô gạch chéo vì OpenAI chưa bao giờ công bố kích thước của nó: con số 1.760 tỷ trên hình là ước tính bị rò rỉ năm 2023, không phải số liệu chính thức.2.8
Size drives cost, because a bigger model needs more data and more computation to train. Meta trained Llama 3.1 405B on more than 15 trillion tokens of text, very roughly the words in a hundred million books, using more than 16,000 of NVIDIA’s H100 GPUs.2.9 Much of that data is drawn from text published on the internet. Stanford’s AI Index estimates that the computing alone for training GPT-4 cost about $78 million, and for Google’s Gemini Ultra about $191 million.2.10
Kích thước kéo theo chi phí, vì mô hình càng lớn càng cần nhiều dữ liệu và nhiều phép tính để training. Meta đã training Llama 3.1 405B trên hơn 15 nghìn tỷ token văn bản, đại khái bằng lượng chữ trong một trăm triệu cuốn sách, dùng hơn 16.000 GPU H100 của NVIDIA.2.9 Một phần lớn lượng dữ liệu ấy lấy từ văn bản đăng tải trên internet. Theo ước tính của báo cáo AI Index thuộc Đại học Stanford, riêng chi phí tính toán để training GPT-4 vào khoảng 78 triệu đô la, còn Gemini Ultra của Google vào khoảng 191 triệu đô la.2.10
Numbers like these explain why the rest of this book is about hardware. Tens of thousands of GPUs cannot sit on one desk. They fill buildings, and the next chapter looks at what those buildings hold.
Những con số như vậy cho thấy vì sao phần còn lại của cuốn sách xoay quanh phần cứng. Hàng chục nghìn GPU không thể nằm gọn trên một chiếc bàn. Chúng lấp đầy cả những tòa nhà, và chương tiếp theo sẽ xem bên trong các tòa nhà ấy có gì.