Chapter 5 of 9Chương 5/9 8 min8 phút
Why GPUs won AIVì sao GPU thắng thế trong AI
To recognise a handwritten letter, a computer cuts the image into pixels and runs the same small calculation on each one. None of those calculations has to wait for another, and that single fact explains why a chip first built for video games became the workhorse of modern AI.
Để nhận ra một chữ cái viết tay, máy tính chia bức ảnh thành từng điểm ảnh và chạy cùng một phép tính nhỏ trên mỗi điểm. Không phép tính nào phải chờ phép tính nào, và chỉ riêng điều đó đã giải thích vì sao một loại chip vốn sinh ra cho trò chơi điện tử lại trở thành cỗ máy chủ lực của AI hiện đại.
In this chapter
Trong chương này
- Why AI work is made of many small, independent calculations
- How a GPU fits that work, with fast memory and cores that can number more than ten thousand
- Why software, not only silicon, put NVIDIA’s GPUs at the centre of AI
- What fifty years of computer-architecture research show about when AI arrived
- How long it takes to design the most complex chips, from the first sketch to the files sent to the factory
- Vì sao khối lượng tính toán của AI gồm vô số phép tính nhỏ, độc lập với nhau
- GPU hợp với loại việc đó ra sao, nhờ bộ nhớ tốc độ cao và số lõi (core) có thể lên tới hơn mười nghìn
- Vì sao phần mềm, chứ không riêng phần cứng, đưa GPU của NVIDIA lên vị trí trung tâm trong AI
- Năm mươi năm nghiên cứu kiến trúc máy tính (computer architecture) cho thấy AI bước vào lĩnh vực này từ khi nào
- Thiết kế những con chip phức tạp nhất mất bao lâu, từ bản phác thảo đầu tiên đến bộ file gửi tới nhà máy
Many small sums can run at the same time
Vô số phép tính nhỏ có thể chạy cùng lúc
AI covers many kinds of work: recognising images, understanding speech and text, and lately the large language models met in chapter 2. Take the simplest case. Someone writes a letter on a screen, and the program has to say whether it is an A, a B, a digit or something else.
AI bao gồm nhiều loại việc: nhận dạng hình ảnh, hiểu lời nói và văn bản, và gần đây là các mô hình ngôn ngữ lớn đã nhắc tới ở chương 2. Hãy lấy trường hợp dễ hình dung nhất. Có người viết một chữ cái lên màn hình, và chương trình phải cho biết đó là chữ A, chữ B, một chữ số hay thứ gì khác.
The usual way to solve it is to break the image into many small pixels and process them all in parallel. Each small calculation reads a patch of neighbouring pixels, but within one layer of the network none of them needs another calculation’s result, so there is no reason to handle them one after another. And the arithmetic is not complicated. A whole layer is almost always one large matrix multiplication: a grid of numbers multiplied by another grid. Each number in the result is found by multiplying pairs of numbers and adding them up, and every such number can be worked out at the same time as the others.
Cách giải thường gặp là chia bức ảnh thành thật nhiều điểm ảnh nhỏ và xử lý tất cả cùng lúc. Mỗi phép tính nhỏ đọc một vùng gồm vài điểm ảnh kề nhau, nhưng trong cùng một lớp của mạng, không phép tính nào cần kết quả của phép tính khác, nên chẳng có lý do gì phải xử lý lần lượt từng điểm. Phép tính cũng không phức tạp. Cả một lớp như thế gần như lúc nào cũng là một phép nhân ma trận lớn: một bảng số nhân với một bảng số khác. Mỗi con số trong kết quả có được bằng cách nhân từng cặp số rồi cộng tất cả lại, và mọi con số như thế đều có thể tính cùng lúc với nhau.
That is the whole shape of the problem: an enormous number of small calculations, all simple, none waiting on another. Chapter 4 described a chip built for exactly that kind of work.
Tóm lại, bài toán có dạng như sau: một khối lượng khổng lồ những phép tính nhỏ, đều dễ, và không phép tính nào phải chờ phép tính nào. Chương 4 đã mô tả một loại chip được thiết kế cho đúng kiểu công việc ấy.
A GPU can hold more than ten thousand cores
Một GPU có thể chứa hơn mười nghìn lõi
The first reason a GPU suits AI is the number of its cores. A GPU can carry more than ten thousand cores, while a current server CPU has at most a few hundred.5.1, 5.2 The calculations are independent, so they can all run together, and each is easy, so no large core is needed.
Lý do đầu tiên khiến GPU (Graphics Processing Unit) hợp với AI nằm ở số lượng lõi. Một GPU có thể có hơn mười nghìn lõi (core), trong khi CPU máy chủ hiện nay có nhiều nhất vài trăm.5.1, 5.2 Các phép tính độc lập với nhau nên có thể chạy cùng lúc, và phép tính nào cũng dễ nên không cần đến lõi lớn.
This is parallel processing at its purest. A CPU would work through the pixels a few at a time, however fast each of its cores might be. A GPU sets all of its cores on them at once.
Đây là xử lý song song ở dạng điển hình nhất. CPU sẽ xử lý các điểm ảnh mỗi lần vài điểm, dù từng lõi của nó nhanh đến đâu. GPU thì huy động tất cả các lõi của mình cùng lúc.
Recent AI GPUs also carry a third kind of unit, the Tensor Core, built for exactly the matrix arithmetic of AI. Much of a modern AI GPU’s speed comes from these units. They work on shorter numbers than usual, whose small rounding errors AI models barely notice, and on the H100 that lets them do four times the work of the previous generation, block for block.5.1
Các GPU AI gần đây còn có thêm một loại khối thứ ba là Tensor Core, một khối chuyên nhân các ma trận nhỏ rồi cộng dồn kết quả trong cùng một thao tác. Tốc độ của một GPU AI hiện đại phần nhiều đến từ các khối này. Chúng tính trên những con số ngắn hơn thường lệ, và sai số làm tròn đi kèm hầu như không làm mô hình AI kém đi. Nhờ vậy, trên cùng một khối, Tensor Core của H100 làm được gấp bốn lần thế hệ trước.5.1
So three kinds of unit do the arithmetic. A GPU core is far smaller than a CPU core, but a GPU has so many of them that it still does much more arithmetic at once. Here is how the three differ.
Như vậy, có ba loại khối cùng làm phần tính toán. Một lõi GPU nhỏ hơn lõi CPU rất nhiều, nhưng GPU có nhiều lõi đến mức vẫn làm được cùng lúc nhiều phép tính hơn hẳn. Bảng dưới đây cho thấy ba loại này khác nhau thế nào.
| CPU core | GPU core (CUDA core) | Tensor Core | |
|---|---|---|---|
| What it is | A large processor that runs a program of its own | A tiny unit that does one sum at a time | A unit that multiplies small grids of numbers in one step |
| How many on one chip | A few hundred at most | More than ten thousand | A few hundred |
| What it is good at | Long programs full of decisions, one step after another | The same simple sum on many numbers at once | The grid arithmetic at the heart of AI |
| Lõi CPU | Lõi GPU (CUDA core) | Tensor Core | |
|---|---|---|---|
| Là gì | Một bộ xử lý lớn, tự chạy chương trình riêng | Một mạch tính nhỏ, mỗi lần làm một phép tính | Một khối nhân các bảng số nhỏ trong một bước |
| Số lượng trên một con chip | Nhiều nhất vài trăm | Hơn mười nghìn | Vài trăm |
| Giỏi việc gì | Chương trình dài, nhiều bước rẽ nhánh, chạy lần lượt từng bước | Cùng một phép tính dễ trên thật nhiều con số một lúc | Phép nhân ma trận, phần việc chính của AI |
Memory has to keep the cores fed
Bộ nhớ phải cấp dữ liệu kịp cho các lõi
The second reason is memory. Chapter 2 showed that an AI model is only accurate when it learns from huge amounts of data. While the model trains or answers, its parameters and the data it is working on at that moment sit in DRAM, the main memory beside the processor. However powerful the compute units are, they can only work as fast as data reaches them. When the link between compute and memory is too slow, the cores sit idle, and that link becomes the bottleneck.
Lý do thứ hai là bộ nhớ. Chương 2 đã cho thấy một mô hình AI chỉ chính xác khi được học từ lượng dữ liệu khổng lồ. Trong lúc training hay trả lời, các tham số của mô hình và phần dữ liệu đang được xử lý nằm trong DRAM, bộ nhớ chính đặt cạnh bộ xử lý. Các khối tính toán mạnh đến đâu cũng không chạy nhanh hơn tốc độ dữ liệu được đưa tới. Khi đường nối giữa phần tính toán và bộ nhớ quá chậm, các lõi phải ngồi chờ, và đường nối ấy trở thành nút thắt cổ chai.
Here the GPU gains a second advantage, from the memory built beside it. The fastest AI GPUs use the high-bandwidth memory (HBM) met in chapter 3: stacks of DRAM chips inside the same package as the GPU, joined to it by a very wide path.5.3 That raises the bandwidth, the amount of data that can move between the compute units and DRAM each second, to about 3 terabytes a second on an H100.5.1 A CPU usually reaches its main memory through ordinary memory modules plugged into the circuit board, and has far less bandwidth to it.
Đến đây, GPU có thêm lợi thế thứ hai, nhờ bộ nhớ đặt ngay bên cạnh nó. Những GPU AI nhanh nhất dùng bộ nhớ băng thông cao (high-bandwidth memory, HBM) đã gặp ở chương 3: những chồng chip DRAM nằm ngay trong cùng một package (phần đóng gói của chip) với GPU, nối với nó qua một đường dẫn rất rộng.5.3 Nhờ vậy băng thông, tức lượng dữ liệu có thể chuyển giữa các khối tính toán và DRAM mỗi giây, lên tới khoảng 3 terabyte mỗi giây trên một GPU H100.5.1 CPU thường nối với bộ nhớ chính qua những thanh nhớ thông thường cắm trên bo mạch, nên băng thông tới bộ nhớ thấp hơn nhiều.
A CPU can still do AI. A model can be trained on a CPU from start to finish. It simply takes far longer and uses far more energy, which at today’s model sizes makes it impractical.
CPU vẫn làm được AI. Hoàn toàn có thể dùng CPU để training (huấn luyện) một mô hình từ đầu đến cuối. Chỉ có điều việc đó mất nhiều thời gian hơn hẳn và tốn nhiều năng lượng hơn hẳn, mà với kích thước mô hình ngày nay thì gần như không khả thi.
Why NVIDIA's GPUs became the default
Vì sao GPU của NVIDIA trở thành lựa chọn mặc định
Other companies design GPUs too, and many newer ones build chips made only for AI. So why did NVIDIA’s GPUs become the default? Part of the answer echoes the three ingredients of chapter 2: models large enough, a great deal of data, and chips fast enough to train them. NVIDIA supplied the chips, but it also spent unusual effort on software for a company that sells chips.
Nhiều công ty khác cũng thiết kế GPU, và không ít công ty mới làm những con chip chỉ dành cho AI. Vậy vì sao GPU của NVIDIA lại trở thành lựa chọn mặc định? Một phần câu trả lời gợi lại ba yếu tố đã bàn ở chương 2: mô hình đủ lớn, thật nhiều dữ liệu, và chip đủ nhanh để training chúng. NVIDIA cung cấp chip, nhưng họ còn đầu tư vào phần mềm nhiều đến mức hiếm thấy ở một công ty bán chip.
NVIDIA was founded in 1993 to bring 3D graphics to games and multimedia.5.4 The early GPU served one purpose, putting images on a screen, and its logic was rigid. Programming it for anything else was slow and awkward, and required knowing its graphics machinery in detail.
NVIDIA ra đời năm 1993 với mục tiêu đưa đồ họa 3D vào trò chơi và các ứng dụng đa phương tiện.5.4 GPU thời đầu chỉ phục vụ một mục đích là hiển thị hình ảnh lên màn hình, và logic bên trong khá cứng nhắc. Muốn lập trình nó cho việc gì khác thì vừa chậm vừa vất vả, lại phải nắm thật chi tiết bộ máy đồ họa của nó.
CUDA changed that. NVIDIA introduced it in late 2006 and released it publicly in 2007.5.5 It let programmers write general-purpose programs for the GPU in a language close to C and C++, the way they already wrote ordinary software.5.6 The parallel power that had only drawn pixels was suddenly open to scientists and researchers. In the image from chapter 2, this is how the GPU became the prince that the sleeping beauty, the neural network, had been waiting for.
CUDA đã thay đổi điều đó. NVIDIA giới thiệu CUDA vào cuối năm 2006 và phát hành rộng rãi năm 2007.5.5 Nền tảng này cho phép lập trình viên viết chương trình đa dụng cho GPU bằng một ngôn ngữ gần với C và C++, đúng như cách họ vẫn viết phần mềm thông thường.5.6 Sức mạnh song song vốn chỉ dùng để vẽ điểm ảnh bỗng mở ra cho giới khoa học và nghiên cứu. Mượn hình ảnh ở chương 2, chính nhờ vậy mà GPU trở thành chàng hoàng tử mà nàng công chúa ngủ trong rừng, tức neural network (mạng nơ-ron), vẫn chờ đợi.
The second half of the answer is how many people already had the hardware. A solution only becomes the industry standard when a broad base of users has it. From the late 1990s through the 2000s, when Intel led CPU design, a great many gaming PCs paired an Intel CPU with an NVIDIA GPU, and gamers were among NVIDIA’s most loyal buyers. Universities and research labs could start with GPUs they already had. Because CUDA made those GPUs easy to program, more people used them, and the more people used them, the further they spread.
Nửa còn lại của câu trả lời là số người đã sẵn có phần cứng trong tay. Một giải pháp chỉ trở thành chuẩn chung của ngành khi có một lượng người dùng đủ rộng. Từ cuối thập niên 1990 đến hết thập niên 2000, khi Intel dẫn đầu về thiết kế CPU, rất nhiều máy tính chơi game dùng CPU Intel ghép với GPU NVIDIA. Game thủ cũng là một trong những nhóm khách hàng trung thành nhất của NVIDIA. Các trường đại học và phòng thí nghiệm có thể bắt đầu ngay với những GPU sẵn có. Vì CUDA giúp lập trình cho các GPU ấy dễ dàng, ngày càng nhiều người dùng chúng, và càng nhiều người dùng thì chúng càng lan rộng.
What architects study now
Giới kiến trúc máy tính đang nghiên cứu gì
The shift spread well beyond one company and reshaped the research of the whole field. The International Symposium on Computer Architecture (ISCA) has run almost every year since 1973 and is one of the oldest and most respected venues for computer architecture research. In 2023 a team of researchers from Google and several universities analysed its first fifty years of papers.5.7
Sự chuyển dịch ấy không bó hẹp trong một công ty mà làm thay đổi hướng nghiên cứu của cả lĩnh vực. International Symposium on Computer Architecture (ISCA) được tổ chức gần như hằng năm từ 1973 và là một trong những diễn đàn lâu đời, uy tín nhất của ngành kiến trúc máy tính. Năm 2023, một nhóm nhà nghiên cứu từ Google và nhiều trường đại học đã phân tích toàn bộ các bài báo trong năm mươi năm đầu của hội nghị này.5.7
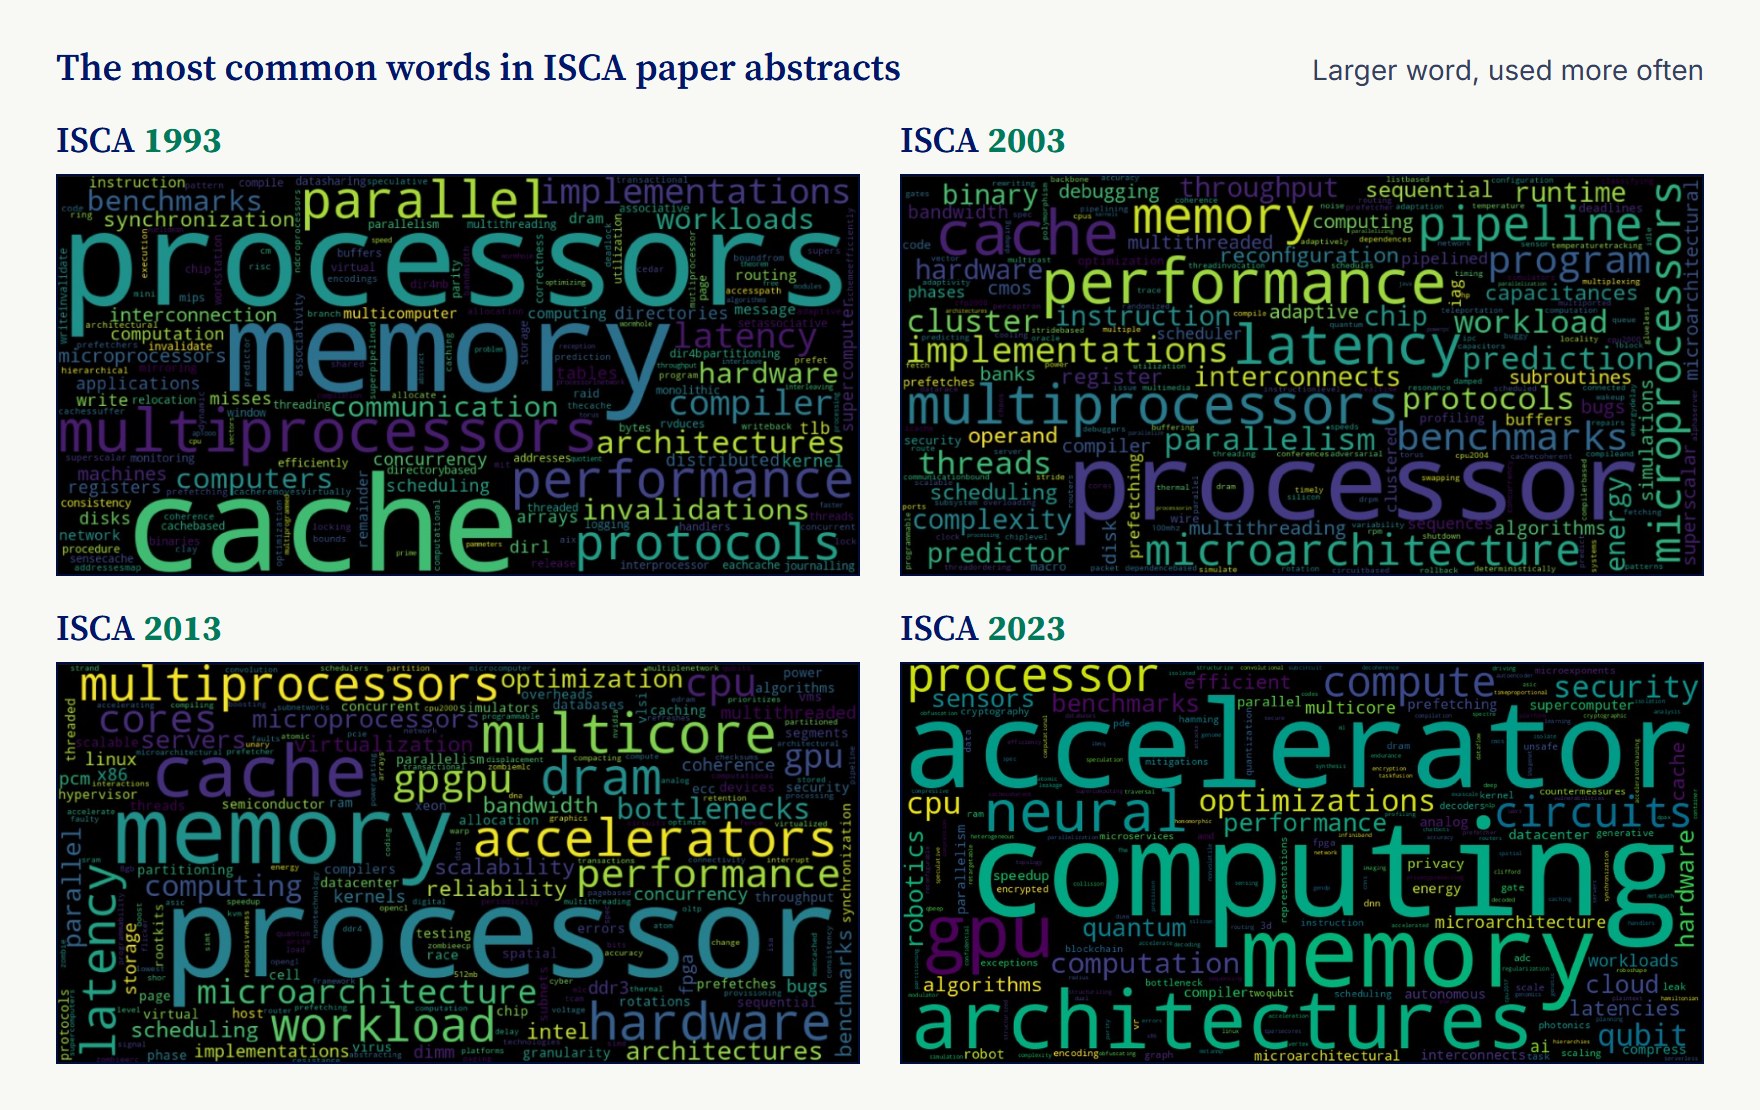
Their word clouds show the change at a glance. In 1993 the words that appear most often in paper abstracts are processors, memory and cache. By 2013 accelerators and gpgpu (general-purpose computing on GPUs) have appeared. In 2023 the largest words are accelerator and computing, with neural and gpu close by.
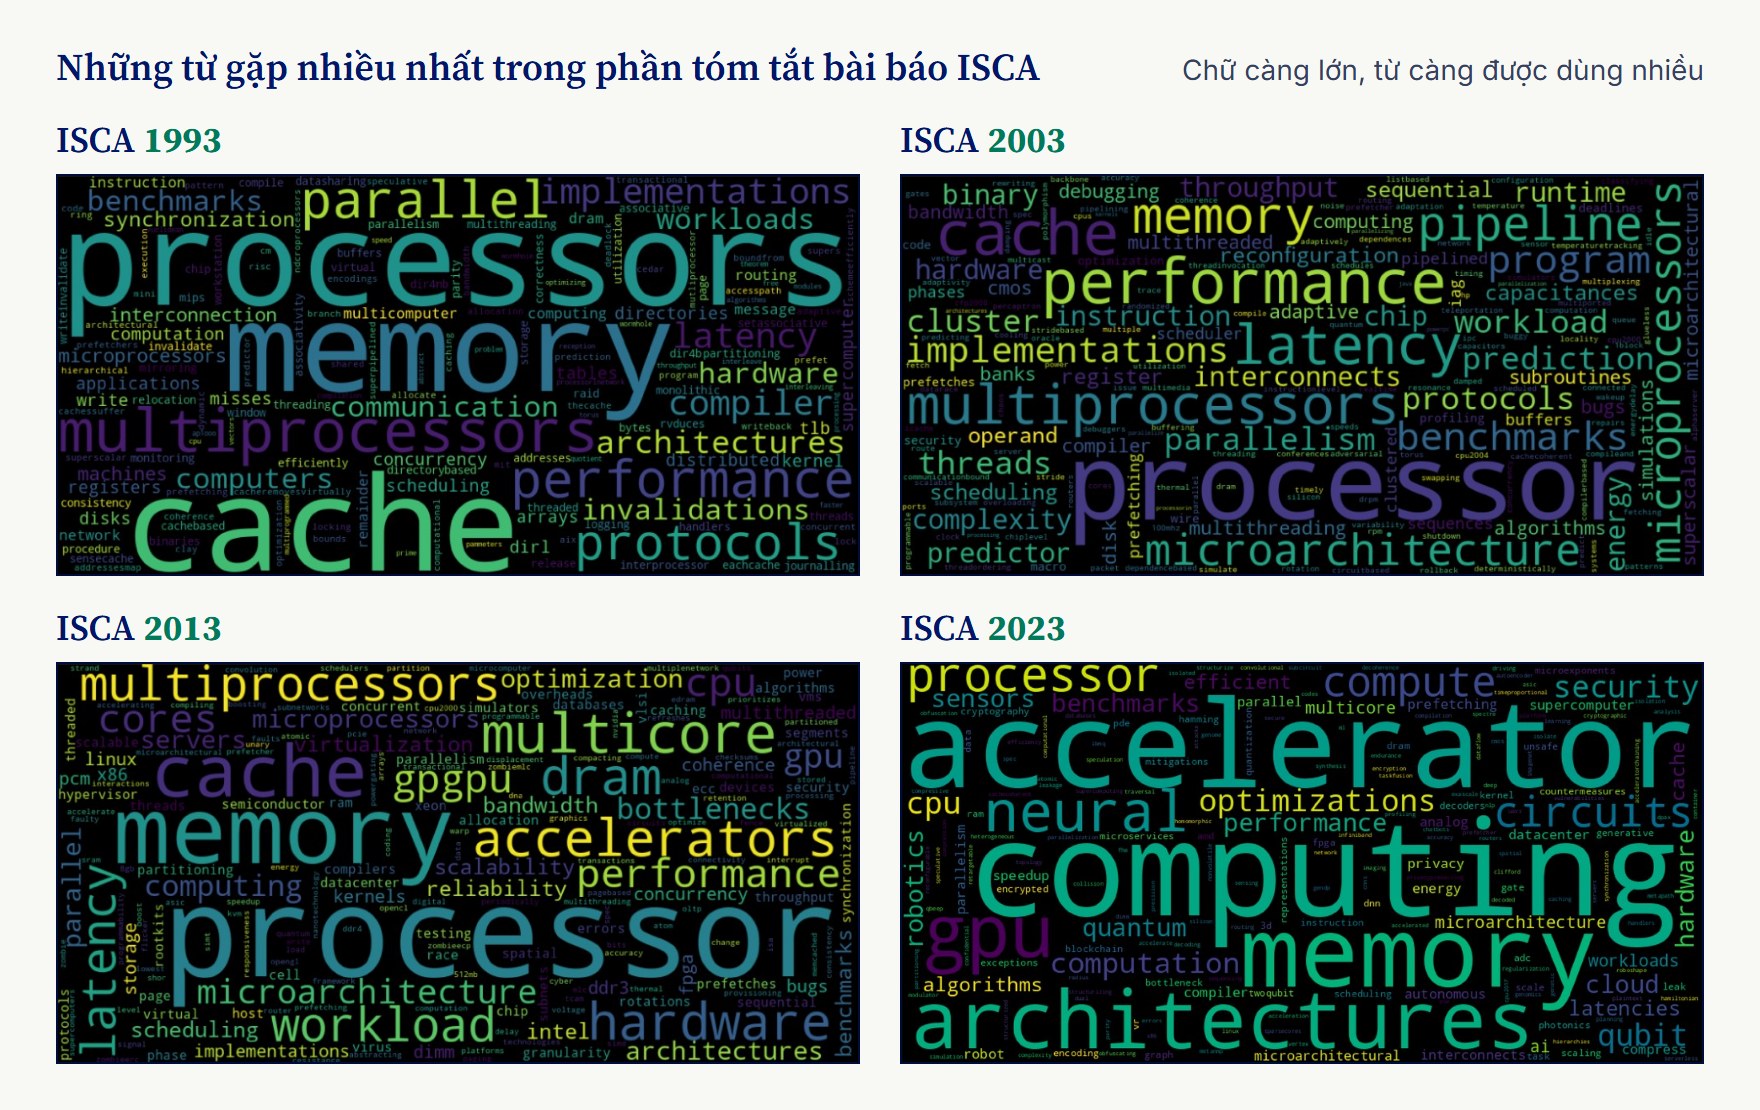
Nhìn qua các đám mây từ của họ là thấy ngay thay đổi ấy. Năm 1993, những từ xuất hiện nhiều nhất trong phần tóm tắt các bài báo là processors, memory và cache. Đến năm 2013 đã có accelerators và gpgpu (tính toán đa dụng trên GPU). Năm 2023, hai từ lớn nhất là accelerator và computing, ngay bên cạnh là neural và gpu.
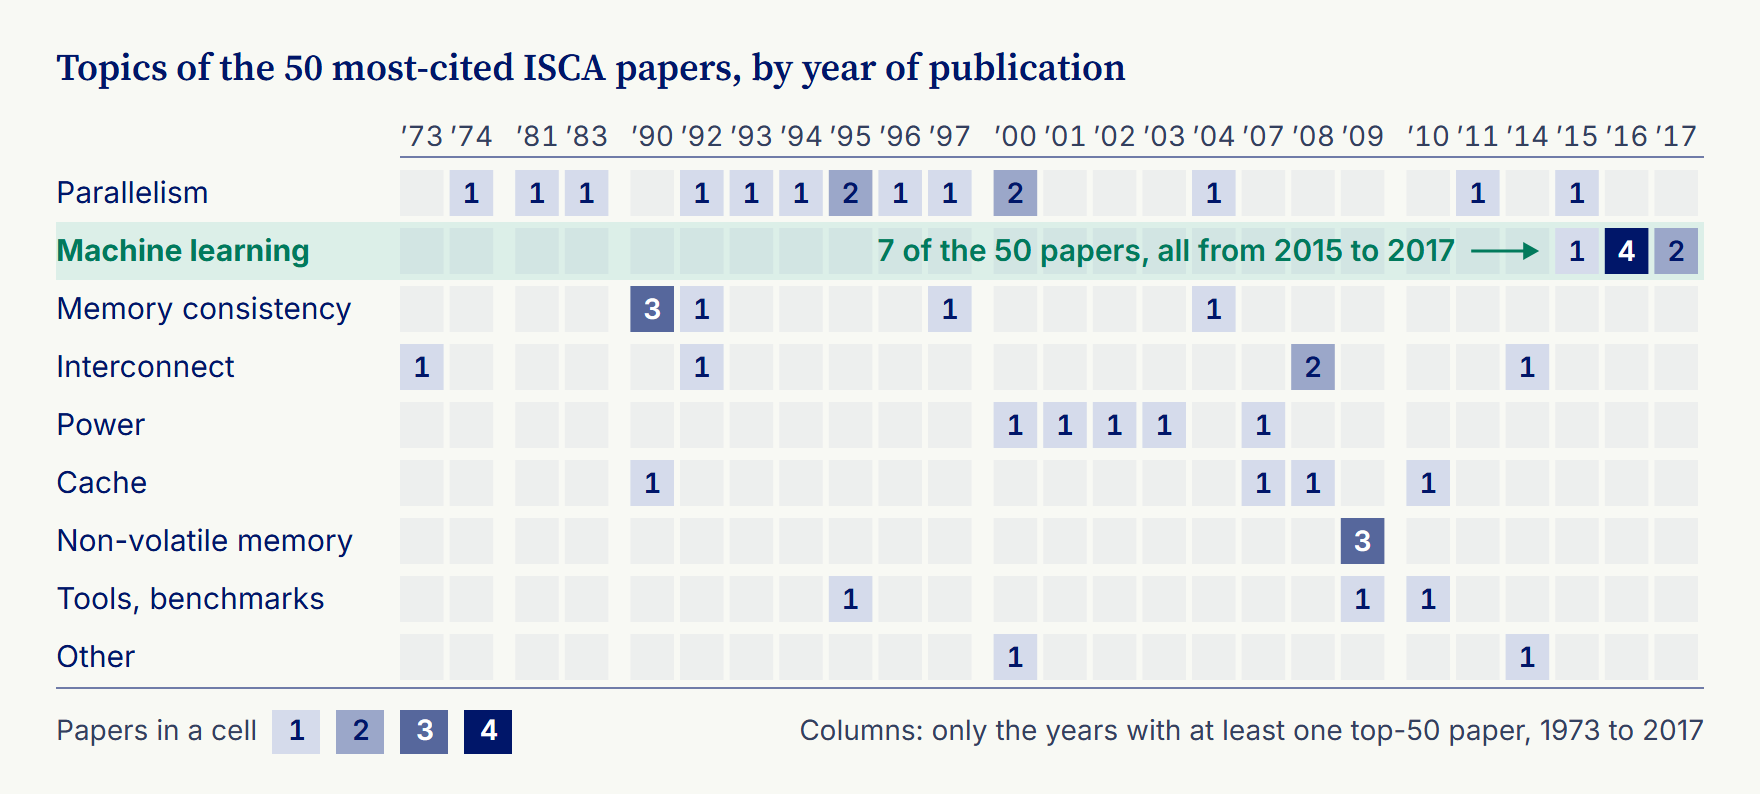
The most-cited papers tell the same story more sharply. Sorted by topic, the fifty most-cited ISCA papers ever show parallelism, memory consistency, interconnect and power spread across the decades. Machine learning does not appear at all until 2015. Then, in just three years from 2015 to 2017, it accounts for seven of the fifty.5.7
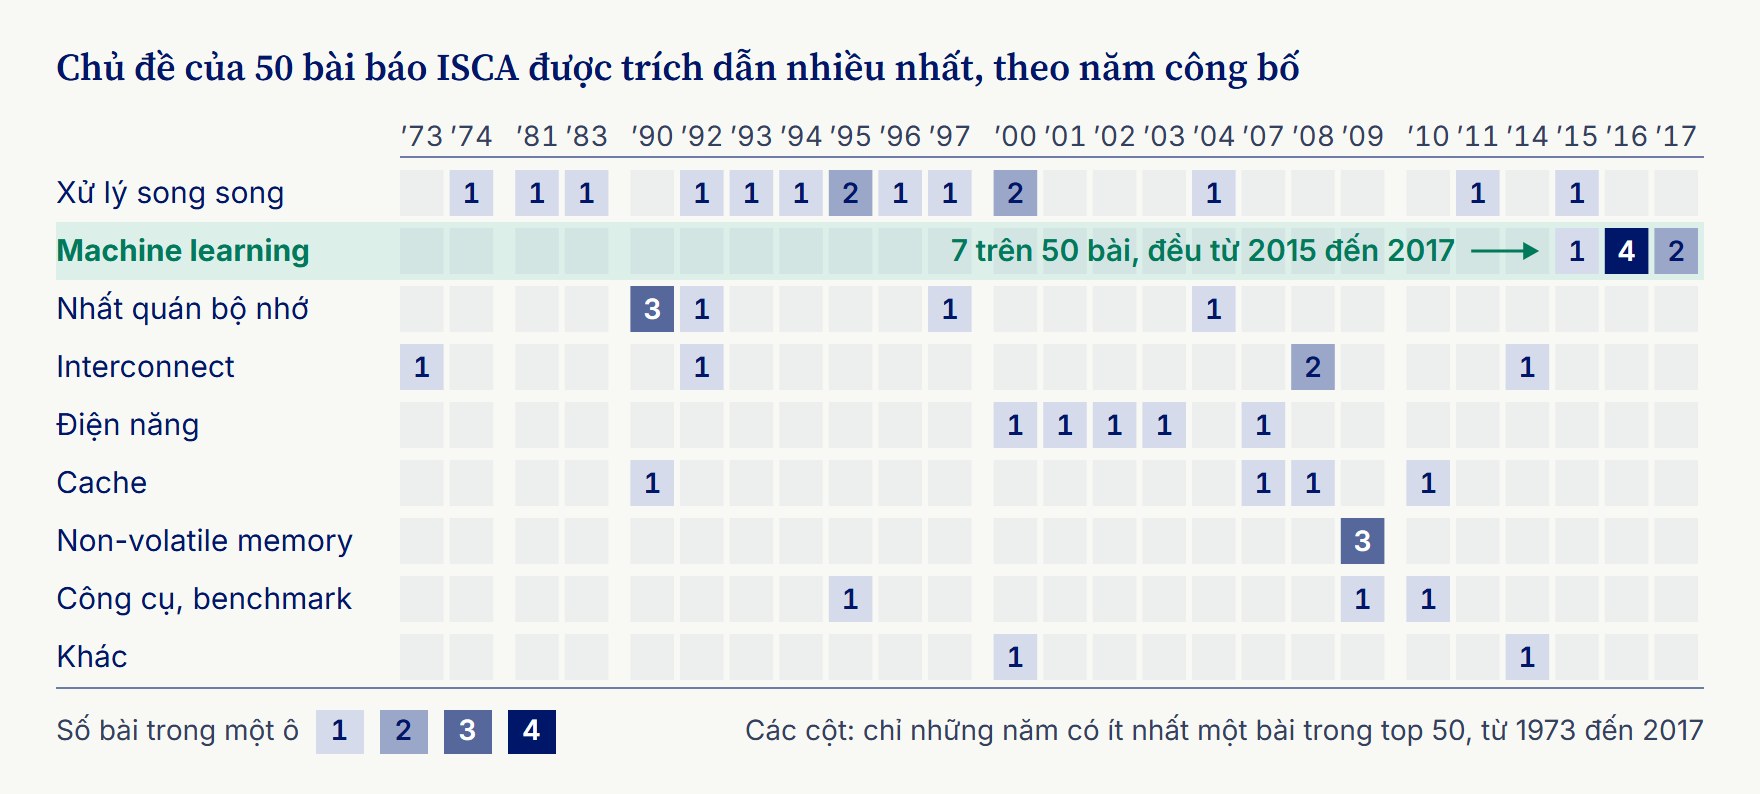
Danh sách những bài báo được trích dẫn nhiều nhất còn cho thấy điều đó rõ hơn nữa. Xếp theo chủ đề, năm mươi bài báo ISCA được trích dẫn nhiều nhất mọi thời kỳ trải đều qua các thập kỷ ở những đề tài như xử lý song song, tính nhất quán bộ nhớ, dây kết nối (interconnect) và điện năng. Machine learning hoàn toàn vắng mặt cho đến năm 2015. Rồi chỉ trong ba năm, từ 2015 đến 2017, nó đã chiếm bảy trên năm mươi bài.5.7
In other words, AI did not grow out of the field’s most influential research. It arrived from outside, once GPUs and neural networks had shown what they could do together, and the field turned toward it within a few years.
Nói cách khác, AI không nảy sinh từ những nghiên cứu có ảnh hưởng nhất của ngành. Nó đến từ bên ngoài, sau khi GPU và neural network cho thấy chúng kết hợp với nhau làm được những gì, và chỉ trong vài năm cả lĩnh vực đã quay sang hướng đó.
The most complex chips take about two to three years to design
Những con chip phức tạp nhất mất khoảng hai đến ba năm để thiết kế
Today’s most complex chips, such as GPUs for AI, hold tens of billions of transistors on a single die, the piece of silicon the chip’s circuits are built on. The largest join two dies in one package and pass two hundred billion transistors. Designing a chip like that from start to finish takes about two to three years.
Những con chip phức tạp nhất ngày nay, như GPU dành cho AI, chứa hàng chục tỷ bóng bán dẫn (transistor) trên một die. Die là miếng silicon mà mạch của con chip được chế tạo trên đó. Loại lớn nhất ghép hai die trong cùng một package, và số transistor vượt hai trăm tỷ. Thiết kế một con chip như thế từ đầu đến cuối mất khoảng hai đến ba năm.
About the first six months: the architects sit together and produce the high-level design, deciding how many components the chip has, where each one goes and roughly how much area it takes.
Khoảng sáu tháng đầu: các kiến trúc sư cùng ngồi lại làm bản thiết kế tổng thể, quyết định con chip có bao nhiêu thành phần, mỗi thành phần đặt ở đâu và chiếm chừng bao nhiêu diện tích.
The next six to nine months: the features are tested on a high-level simulation model, a program that behaves like the future chip, and the design is fine-tuned along the way.
Sáu đến chín tháng tiếp theo: các tính năng được chạy thử trên một mô hình mô phỏng mức cao, tức một chương trình hoạt động giống như con chip sắp làm ra, và thiết kế liên tục được tinh chỉnh trong quá trình đó.
About a year after that: the features are written out in Register-Transfer Level (RTL) code, which describes how data moves between the chip’s registers on every clock cycle. Alongside, a very large team checks that each function works and that the chip reaches its targets for performance and power by the final checkpoint.
Khoảng một năm sau đó: các tính năng được viết thành mã Register-Transfer Level (RTL), mô tả cách dữ liệu di chuyển giữa các thanh ghi của chip qua từng chu kỳ xung nhịp. Song song với việc này, một đội ngũ rất đông kiểm tra xem từng chức năng có chạy đúng không, và con chip có đạt các mục tiêu về hiệu năng, điện năng trước mốc kiểm tra cuối cùng hay không.
When the RTL is finished, it still is not a chip. In the last months, overlapping the end of the RTL work, the back end turns the code into a physical layout in a few steps.5.8
RTL xong rồi vẫn chưa có con chip. Trong những tháng cuối, chồng lên giai đoạn cuối của khâu RTL, phần back end biến mã RTL thành bản bố trí vật lý của con chip qua vài bước.5.8
| Step | What happens |
|---|---|
| Turn the code into logic gates (synthesis) | Software turns the RTL code into logic gates and the wires between them |
| Place the parts and draw the wires (place-and-route) | Each block and gate gets its spot on the die, then the wires are drawn |
| Check that every signal arrives on time (timing signoff) | Every signal must arrive in time at the target clock speed, and none too early |
| Build in ways to test the chip (design for test, DFT) | Extra circuits let each chip be tested after it is made5.9 |
| Check the drawing against the factory’s rules and against the circuit (physical verification) | The layout must meet the foundry’s manufacturing rules (design rule check, DRC) and still match the circuit (layout versus schematic, LVS) |
| Send the final drawing to the factory (GDSII, tape-out) | The layout is saved as a GDSII file, and handing it over is the tape-out |
| Bước | Diễn ra những gì |
|---|---|
| Chuyển mã thành cổng logic (synthesis) | Phần mềm chuyển mã RTL thành các cổng logic và dây nối giữa chúng |
| Xếp chỗ và đi dây (place-and-route) | Mỗi khối, mỗi cổng được xếp chỗ trên die, rồi dây được đi giữa chúng |
| Kiểm tra xem mọi tín hiệu có đến đúng lúc không (timing signoff) | Mọi tín hiệu phải đến kịp ở tốc độ xung nhịp mục tiêu, và không tín hiệu nào đến quá sớm |
| Cài sẵn cách kiểm tra con chip (design for test, DFT) | Mạch phụ được thêm vào để kiểm tra được từng con chip sau khi làm ra5.9 |
| Đối chiếu bản vẽ với quy tắc của nhà máy và với mạch (physical verification) | Bản bố trí phải đạt các quy tắc sản xuất của foundry (design rule check, DRC) và vẫn khớp với mạch (layout versus schematic, LVS) |
| Gửi bản vẽ cuối cùng cho nhà máy (GDSII, tape-out) | Bản bố trí được lưu thành file GDSII, và bàn giao file này chính là bước tape-out |
At tape-out the chip still exists only as a file. NVIDIA, like many chip companies, designs its chips and sends the finished layout to a foundry, a company that manufactures chips to other companies’ designs, such as TSMC. How that foundry turns a design into billions of working transistors is the subject of the next chapter.
Đến lúc tape-out, con chip vẫn chỉ là một file. NVIDIA, giống như nhiều công ty chip khác, tự thiết kế chip của mình rồi gửi bản bố trí hoàn chỉnh cho một foundry, tức công ty chuyên sản xuất chip theo thiết kế của công ty khác, chẳng hạn TSMC. Foundry biến bản thiết kế ấy thành hàng tỷ transistor chạy được như thế nào là chủ đề của chương sau.