Chapter 1 of 10Chương 1/10 9 min9 phút
Why packaging became the new gameVì sao đóng gói chip trở thành cuộc chơi mới
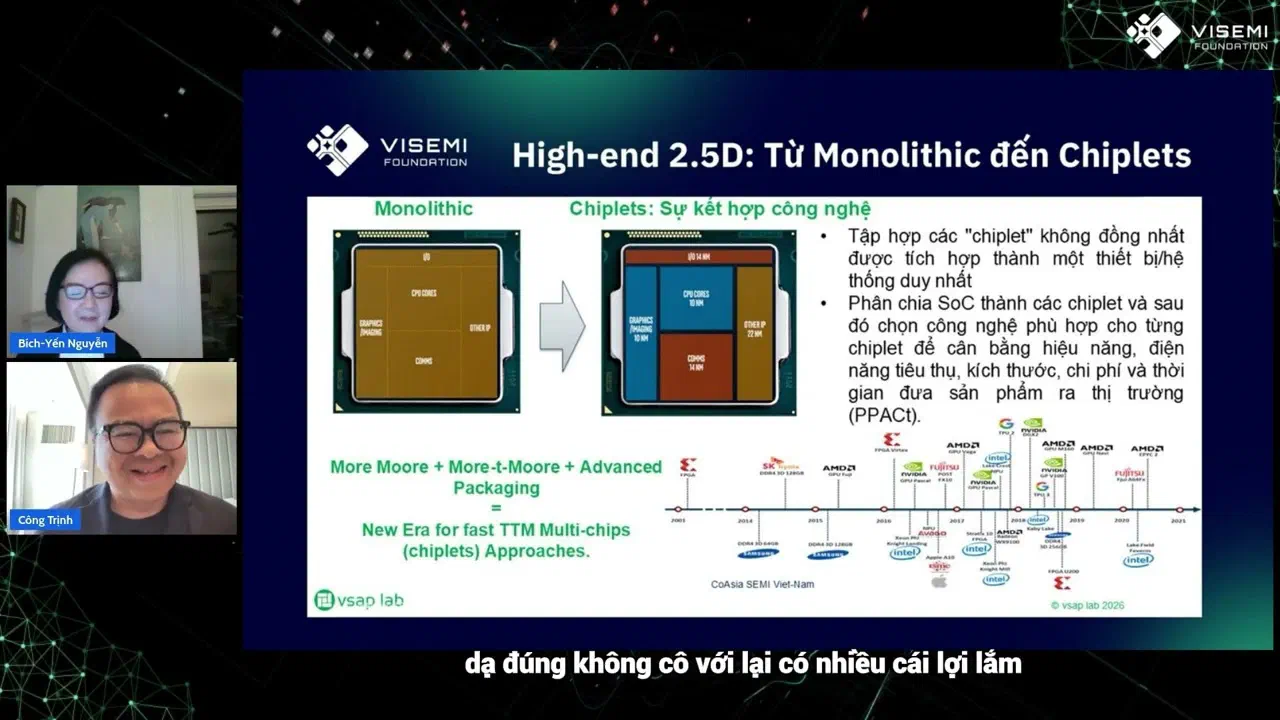
For about sixty years, chips got faster and cheaper mainly by shrinking their transistors. That road has grown steep. For the parts of a chip that barely shrink, a new node now costs more than it returns, so more and more big chips are split into chiplets, smaller chips joined again in one package, and the package that joins them decides how well they work.
Suốt khoảng sáu mươi năm, chip ngày càng nhanh hơn và rẻ hơn chủ yếu nhờ thu nhỏ bóng bán dẫn (transistor). Con đường ấy giờ đã dốc hơn nhiều. Với những phần của con chip hầu như không thu nhỏ được, chuyển sang một tiến trình bán dẫn (technology node) mới nay tốn kém hơn lợi ích nó mang lại. Vì thế, ngày càng nhiều chip lớn được tách thành các chiplet, tức những con chip nhỏ hơn được ghép lại trong cùng một package (phần đóng gói của chip), và chính phần đóng gói ấy quyết định chúng chạy tốt đến đâu.
In this chapter
Trong chương này
- Why each new node costs more to build and to design for
- Which parts of a chip gain from a new node, and which hardly do
- Why a bigger die yields worse
- How a system on chip is split into chiplets, each on the node that suits it
- Why the package that joins the chiplets is now part of the design
- Vì sao mỗi tiến trình mới lại tốn kém hơn, cả khi chế tạo lẫn khi thiết kế
- Phần nào của con chip được lợi khi chuyển sang tiến trình mới, phần nào gần như không
- Vì sao die càng lớn, tỷ lệ thành phẩm càng thấp
- Một SoC được tách thành nhiều chiplet ra sao, mỗi chiplet dùng tiến trình hợp với nó
- Vì sao khâu đóng gói chip nối các chiplet giờ trở thành một phần của thiết kế
Shrinking transistors costs more each time
Mỗi lần thu nhỏ transistor lại tốn kém hơn
Each new node tends to cost more than the last, both to build and to design for, yet demand for computing has never stopped climbing. Morgan Stanley’s 2009 chart of computing cycles, from mainframes through minicomputers, PCs and the desktop internet to mobile, shows each cycle reaching roughly ten times as many devices or users as the one before, the mobile figure then a forecast.1.1 AI is the newest wave. The industry is building to keep up: SEMI expected 18 new fab construction projects to start in 2025, and Deloitte predicted in 2022 that more than one million additional skilled workers would be needed worldwide by 2030.1.2, 1.3
Mỗi tiến trình mới thường tốn kém hơn tiến trình trước, cả khi chế tạo lẫn khi thiết kế, nhưng nhu cầu tính toán chưa bao giờ ngừng tăng. Biểu đồ các chu kỳ điện toán năm 2009 của Morgan Stanley, từ máy tính lớn, máy tính mini, máy tính cá nhân, internet trên máy để bàn đến internet di động, cho thấy mỗi chu kỳ đạt số thiết bị hoặc người dùng gấp khoảng mười lần chu kỳ trước. Con số của internet di động khi ấy mới là dự báo.1.1 AI là làn sóng mới nhất. Ngành bán dẫn đang mở rộng để theo kịp. SEMI dự kiến 18 dự án nhà máy sản xuất chip (fab) mới sẽ khởi công trong năm 2025. Còn Deloitte, trong một dự báo năm 2022, cho rằng đến năm 2030 thế giới sẽ cần thêm hơn một triệu lao động có tay nghề cho ngành này.1.2, 1.3
For decades, meeting that demand meant shrinking transistors. The industry followed Moore's Law, the observation that the number of transistors on a chip doubles about every two years. Each new technology node, a generation of the manufacturing process, shrank a transistor’s length and width to about 0.7 times the last, halving its area. Under Dennard scaling, the smaller transistor switched faster, and because its voltage was lowered in step with its size, each square millimetre of chip ran no hotter. A transistor’s gate was a few micrometres long in the 1970s; today’s leading nodes are named in nanometres.
Suốt nhiều thập kỷ, đáp ứng nhu cầu ấy đồng nghĩa với thu nhỏ transistor. Ngành bán dẫn đi theo Định luật Moore, nhận định rằng số transistor trên một con chip tăng gấp đôi sau khoảng hai năm. Mỗi tiến trình mới, tức một thế hệ quy trình chế tạo, thu chiều dài và chiều rộng của transistor xuống còn khoảng 0,7 lần thế hệ trước, nên diện tích giảm một nửa. Theo Dennard scaling, transistor nhỏ hơn thì chuyển mạch nhanh hơn, và vì điện áp được hạ cùng nhịp với kích thước nên mỗi milimét vuông chip không nóng thêm. Cổng của transistor những năm 1970 dài vài micromet; các tiến trình hàng đầu ngày nay được gọi tên bằng nanomet.
Smaller also made transistors harder to switch off. In the original flat, or planar, transistor the gate sits on top of the channel it controls, and at small sizes it loses its grip: current leaks through even when the transistor should be off, and the wasted power turns into heat. The fix was a new shape, the FinFET: the channel stands up as a thin fin, and the gate wraps around three sides of it. Intel announced the first FinFET made in high volume, its 22 nm Tri-Gate transistor, in May 2011 and shipped chips built with it in April 2012.1.4, 1.5 As transistors kept shrinking, even the fin’s gate began to lose its grip, so gate-all-around (GAA) nanosheet transistors wrap the gate all the way around the channel to restore it.
Thu nhỏ cũng khiến transistor khó tắt hẳn hơn. Ở loại ban đầu, tức planar transistor (transistor phẳng), cổng nằm trên kênh dẫn mà nó điều khiển; khi kích thước quá nhỏ, cổng không còn “giữ” nổi kênh dẫn, dòng điện rò rỉ qua ngay cả khi transistor lẽ ra đã tắt, và phần điện năng hao phí ấy biến thành nhiệt. Lời giải là một hình dạng transistor mới, gọi là FinFET: kênh dẫn dựng đứng thành một chiếc “vây” mỏng, và cổng bọc lấy ba mặt của vây. Tháng 5/2011, Intel công bố FinFET đầu tiên được đưa vào sản xuất hàng loạt, transistor Tri-Gate 22 nm, rồi xuất xưởng những con chip dùng nó từ tháng 4/2012.1.4, 1.5 Khi transistor tiếp tục nhỏ đi, cổng bọc ba mặt của vây cũng dần mất kiểm soát, nên transistor nanosheet kiểu gate-all-around (GAA) bọc cổng kín quanh kênh dẫn để giành lại quyền điều khiển.
TSMC said in January 2026 that its 2 nm node (N2) entered high-volume manufacturing in the fourth quarter of 2025, and Intel said in October 2025 that its 18A node was set to reach high-volume production at Fab 52 in Arizona by the end of that year.1.6, 1.7 Every step like this needs new materials and new machines, and more of them. A leading-edge chip is patterned through many dozens of photomasks, the stencils that print each layer’s pattern, far more than early chips needed, so chips spend longer in the fab and the fab itself costs more.
Tháng 1/2026, TSMC cho biết tiến trình 2 nm (N2) của hãng đã vào sản xuất hàng loạt từ quý 4/2025. Còn Intel, vào tháng 10/2025, cho biết tiến trình 18A sẽ đạt sản lượng lớn tại Fab 52 ở Arizona trước cuối năm đó.1.6, 1.7 Mỗi bước tiến như vậy đòi hỏi vật liệu mới, máy móc mới, và số máy cũng nhiều hơn. Một con chip ở mức tiên tiến nhất phải qua nhiều chục mặt nạ quang (photomask), tức những tấm khuôn in hình mẫu cho từng lớp, nhiều hơn hẳn các con chip thời đầu, nên chip nằm trong fab lâu hơn và bản thân fab cũng đắt hơn.
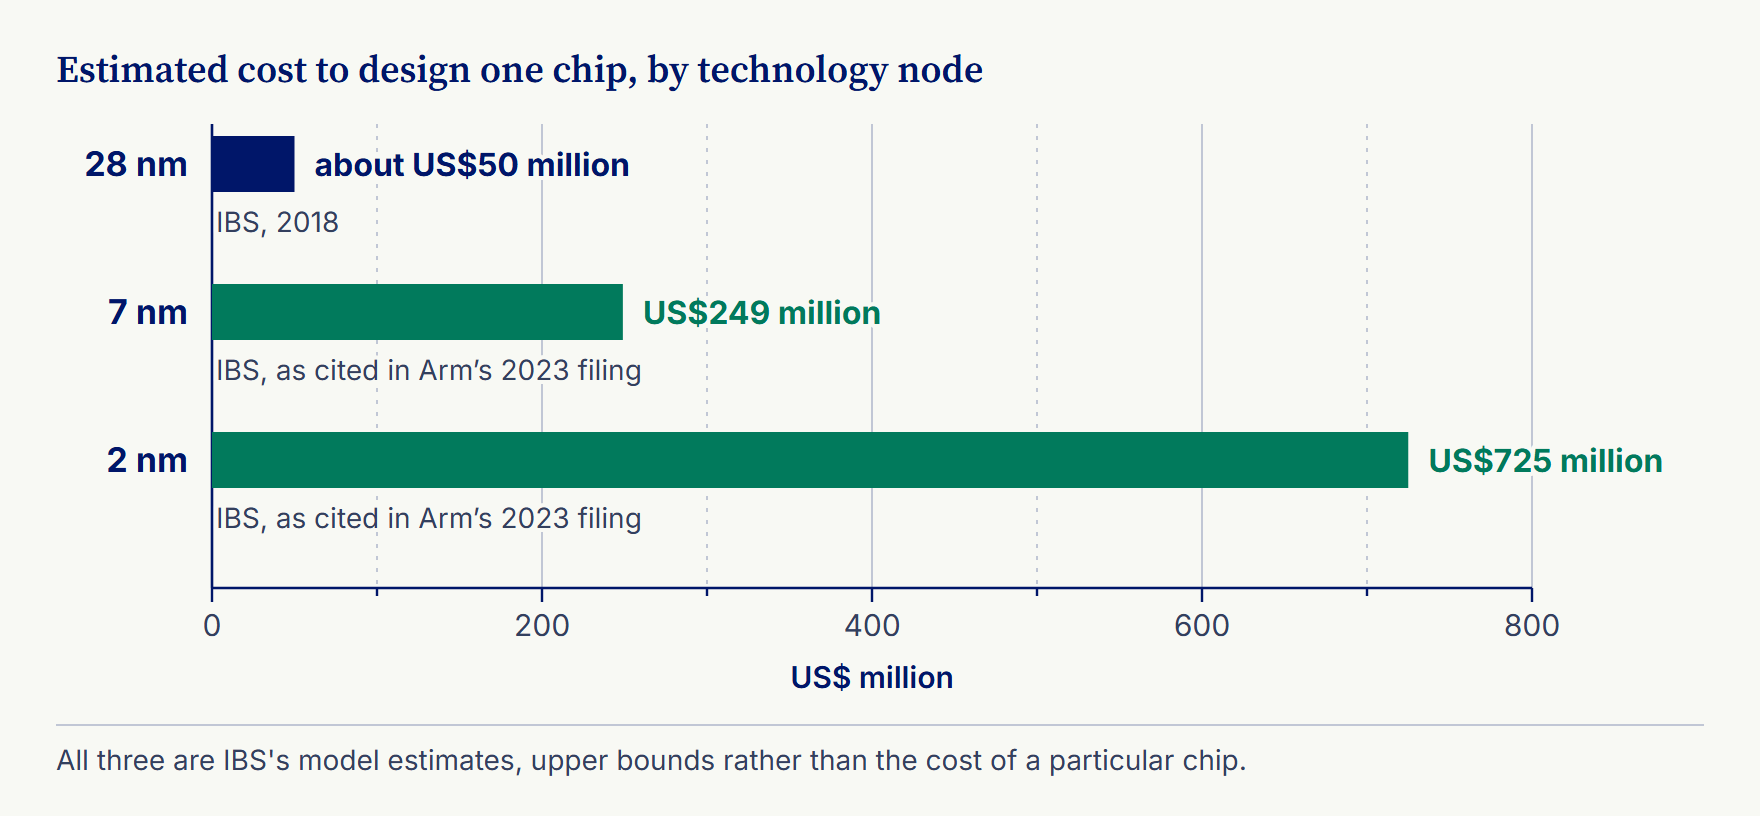
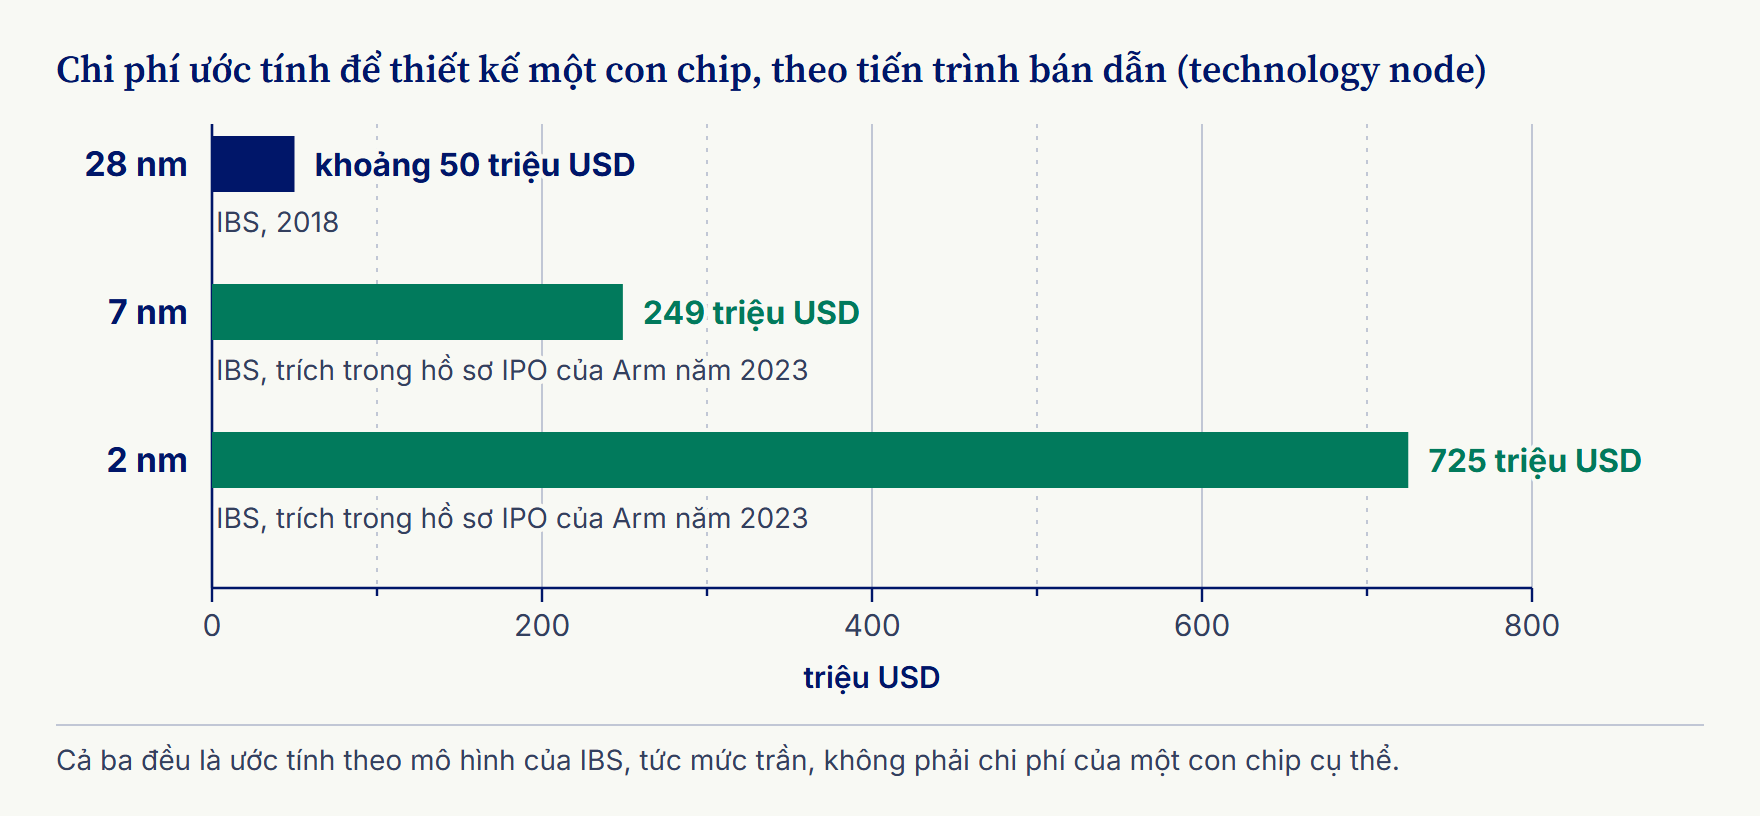
Designing a chip for each new node costs more too. IBS, a consultancy that models chip costs, estimated about US$50 million to design a chip at 28 nm in 2018, and US$249 million at 7 nm and US$725 million at 2 nm in its July 2022 model, as cited in Arm’s 2023 filing (plate 1.1).1.8, 1.9 From 7 nm to 2 nm, the cost nearly triples. These are models of a chip designed from a blank page. Real projects reuse earlier work and often cost much less, especially AI chips built from one simple block repeated many times.1.8 Design, verification and the set of masks are paid for once, however many chips are later sold, so they are called non-recurring engineering (NRE).
Thiết kế một con chip cho mỗi tiến trình mới cũng đắt hơn. IBS, một công ty tư vấn chuyên lập mô hình chi phí chip, ước tính năm 2018 rằng thiết kế một con chip ở tiến trình 28 nm tốn khoảng 50 triệu USD. Theo mô hình tháng 7/2022 của IBS mà Arm dẫn lại trong hồ sơ năm 2023, con số này là 249 triệu USD ở 7 nm và 725 triệu USD ở 2 nm (hình 1.1).1.8, 1.9 Từ 7 nm đến 2 nm, chi phí tăng gần gấp ba. Đây là mô hình cho một con chip thiết kế từ đầu. Dự án thực tế dùng lại nhiều phần đã có nên thường tốn ít hơn nhiều, nhất là những chip AI được dựng từ một khối đơn giản lặp lại rất nhiều lần.1.8 Tiền thiết kế, kiểm định và bộ mặt nạ chỉ phải trả một lần, dù sau đó bán được bao nhiêu chip, nên được gọi là NRE (non-recurring engineering), chi phí kỹ thuật trả một lần.
Only part of a chip gains from a new node
Chỉ một phần con chip được lợi khi chuyển sang tiến trình mới
A chip is made as one of many copies on a wafer, a thin disc of silicon, and each copy, once cut out, is a die. A phone processor is usually a system on chip (SoC), and so are many PC processors: one die that holds the processor cores, graphics, the on-chip memory called cache, the circuits that connect to the outside world and often the communications circuits. Made in one piece, or monolithic, the whole SoC is built on one node, so every block pays the newest node’s price for each square millimetre of silicon.
Chip được làm hàng loạt trên một wafer, tức một đĩa silicon mỏng; mỗi con chip, khi đã cắt rời, là một die. Bộ xử lý của điện thoại thường là một SoC (System on Chip), và nhiều bộ xử lý máy tính cũng vậy: một die chứa các lõi xử lý, khối đồ họa, bộ nhớ đệm (cache) ngay trên chip, các mạch giao tiếp với bên ngoài và thường có cả khối truyền tin. Khi được làm liền một khối, tức nguyên khối, cả SoC phải dùng chung một tiến trình, nên khối nào cũng phải trả giá của tiến trình mới nhất cho từng milimét vuông silicon.
The blocks do not gain equally from that price. Logic, the circuits that compute, keeps shrinking well. SRAM, the fast memory built into the chip, shrinks less with each node. Analog circuits and the input/output (I/O) circuits that carry signals on and off the chip hardly shrink at all, and nor do radio-frequency (RF) circuits. One of AMD’s chiplet architects said in 2023 that logic still scales, SRAM is harder and analog is not scaling, which is why AMD had already moved its analog circuits onto a separate I/O chiplet.1.10
Không phải khối nào cũng được lợi như nhau từ cái giá ấy. Mạch logic, phần làm nhiệm vụ tính toán, vẫn thu nhỏ tốt. SRAM, bộ nhớ tốc độ cao nằm ngay trên chip, mỗi tiến trình lại thu nhỏ được ít hơn. Mạch analog và mạch I/O (vào/ra), phần đưa tín hiệu vào và ra khỏi chip, gần như không nhỏ đi, và mạch RF (tần số vô tuyến) cũng vậy. Năm 2023, một kiến trúc sư chiplet của AMD cho biết mạch logic vẫn thu nhỏ tốt, SRAM thì khó hơn, còn mạch analog đã không còn nhỏ đi. Vì thế AMD đã tách mạch analog sang một chiplet I/O riêng.1.10
Building a whole SoC on the newest node therefore means paying top price for a good deal of silicon that gives little back. That is half the case for splitting a chip; the other half is how many good dies a wafer gives.
Như vậy, làm cả SoC trên tiến trình mới nhất nghĩa là trả giá cao nhất cho một lượng silicon đáng kể mà gần như không đem lại lợi ích gì thêm. Đó mới chỉ là một nửa lý do để tách chip; nửa còn lại nằm ở số die tốt mà mỗi wafer làm ra được.
Why a bigger die yields worse
Vì sao die càng lớn, tỷ lệ thành phẩm càng thấp
No fab is perfectly clean. Specks of dust and tiny flaws in the layers land at random across every wafer, and a die with a flaw in the wrong place does not work. The share of dies that work is the yield, and the number of flaws per unit of area is the defect density. A bigger die is a bigger target, so it is more likely to catch at least one flaw. In the simplest model, a Poisson model, yield falls exponentially as a die’s area grows.
Không có fab nào sạch tuyệt đối. Bụi và những khuyết tật rất nhỏ trong các lớp vật liệu xuất hiện ngẫu nhiên khắp mặt wafer, và die nào dính khuyết tật ở chỗ hiểm thì không chạy. Tỷ lệ die chạy được gọi là tỷ lệ thành phẩm (yield), còn số khuyết tật trên một đơn vị diện tích gọi là defect density (mật độ khuyết tật). Die càng lớn thì càng dễ dính ít nhất một khuyết tật. Theo mô hình đơn giản nhất, mô hình Poisson, yield giảm theo hàm mũ khi diện tích die tăng.
Plate 1.2 puts numbers on it. At a defect density of 0.1 per square centimetre, 90.5% of 100 mm² dies work, 81.9% of 200 mm² dies, and only 44.9% of 800 mm² dies. That defect density is illustrative, chosen to show the shape of the curve: real values differ from node to node and from fab to fab.
Hình 1.2 đưa ra các con số cụ thể. Với defect density 0,1 khuyết tật trên mỗi centimét vuông, 90,5% số die 100 mm² chạy được, với die 200 mm² là 81,9%, còn die 800 mm² chỉ 44,9%. Con số 0,1 này chỉ mang tính minh họa, được chọn để thấy rõ hình dạng đường cong: giá trị thật khác nhau theo từng tiến trình và từng fab.
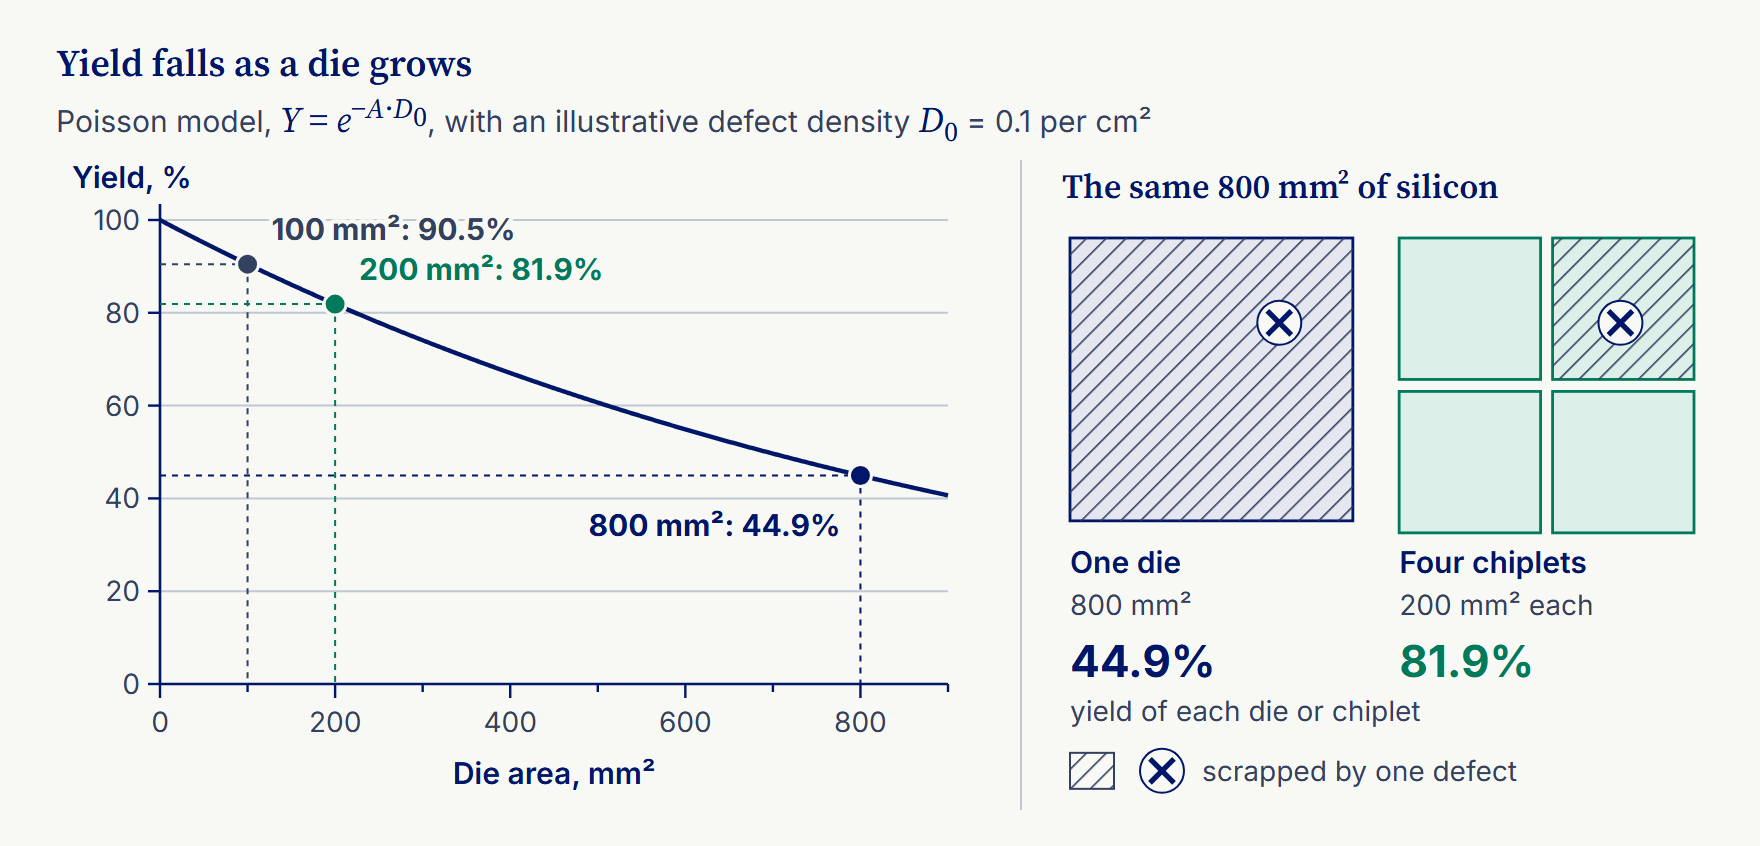
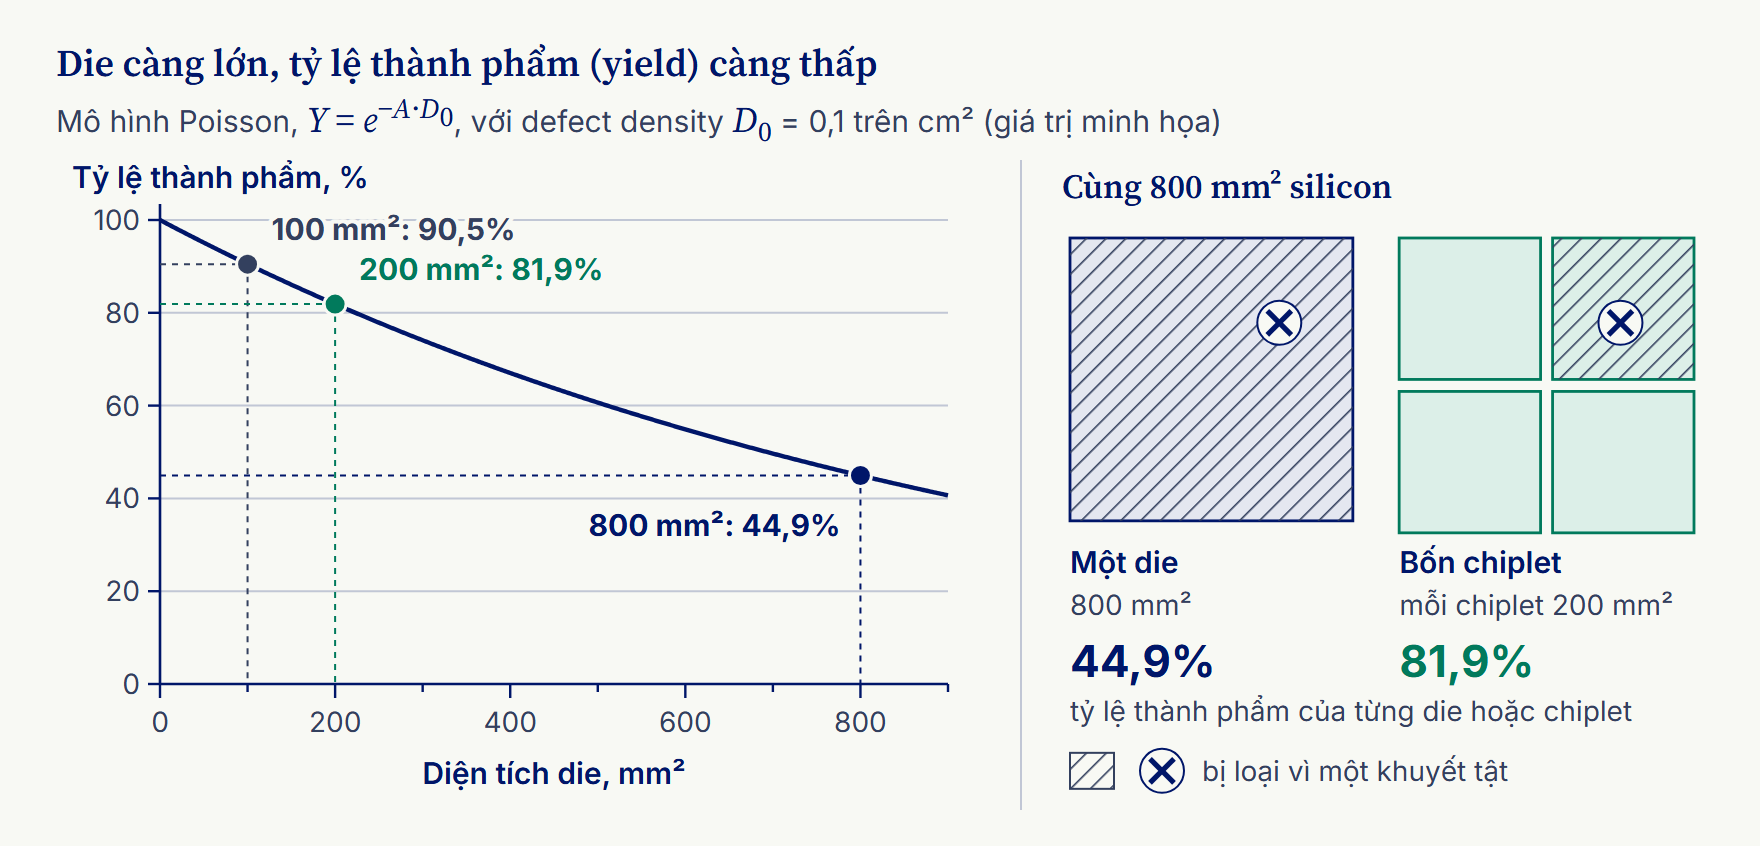
Now cut the 800 mm² design into four 200 mm² chiplets. Each chiplet yields 81.9%, and a flaw now scraps 200 mm² of silicon instead of 800. The gain holds only if every chiplet is tested before it is packaged, so that only good ones are joined; chapter 8 returns to that testing. Even then, the gain is smaller than the yields alone suggest: the circuits that link the chiplets take extra silicon, and a few good chiplets are lost in assembly. On a single big die, one flaw anywhere throws the whole die away, and on the newest nodes each of those dies is expensive.
Giờ hãy cắt bản thiết kế 800 mm² ấy thành bốn chiplet 200 mm². Mỗi chiplet vẫn có yield 81,9%, và một khuyết tật giờ chỉ làm hỏng 200 mm² silicon thay vì 800 mm². Cái lợi này chỉ có được khi từng chiplet đều được kiểm thử trước khi đóng gói, để chỉ những chiplet tốt mới được ghép với nhau; chương 8 sẽ trở lại việc kiểm thử này. Ngay cả khi ấy, cái lợi vẫn nhỏ hơn những gì các con số yield cho thấy: các mạch nối giữa các chiplet cần thêm silicon, và một số chiplet tốt vẫn hỏng trong khâu lắp ráp. Còn với một die lớn, chỉ một khuyết tật ở bất cứ đâu cũng khiến cả die bị bỏ, mà ở các tiến trình mới nhất, die nào cũng đắt.
Each chiplet is made on the node that suits it
Mỗi chiplet được làm trên tiến trình hợp với nó
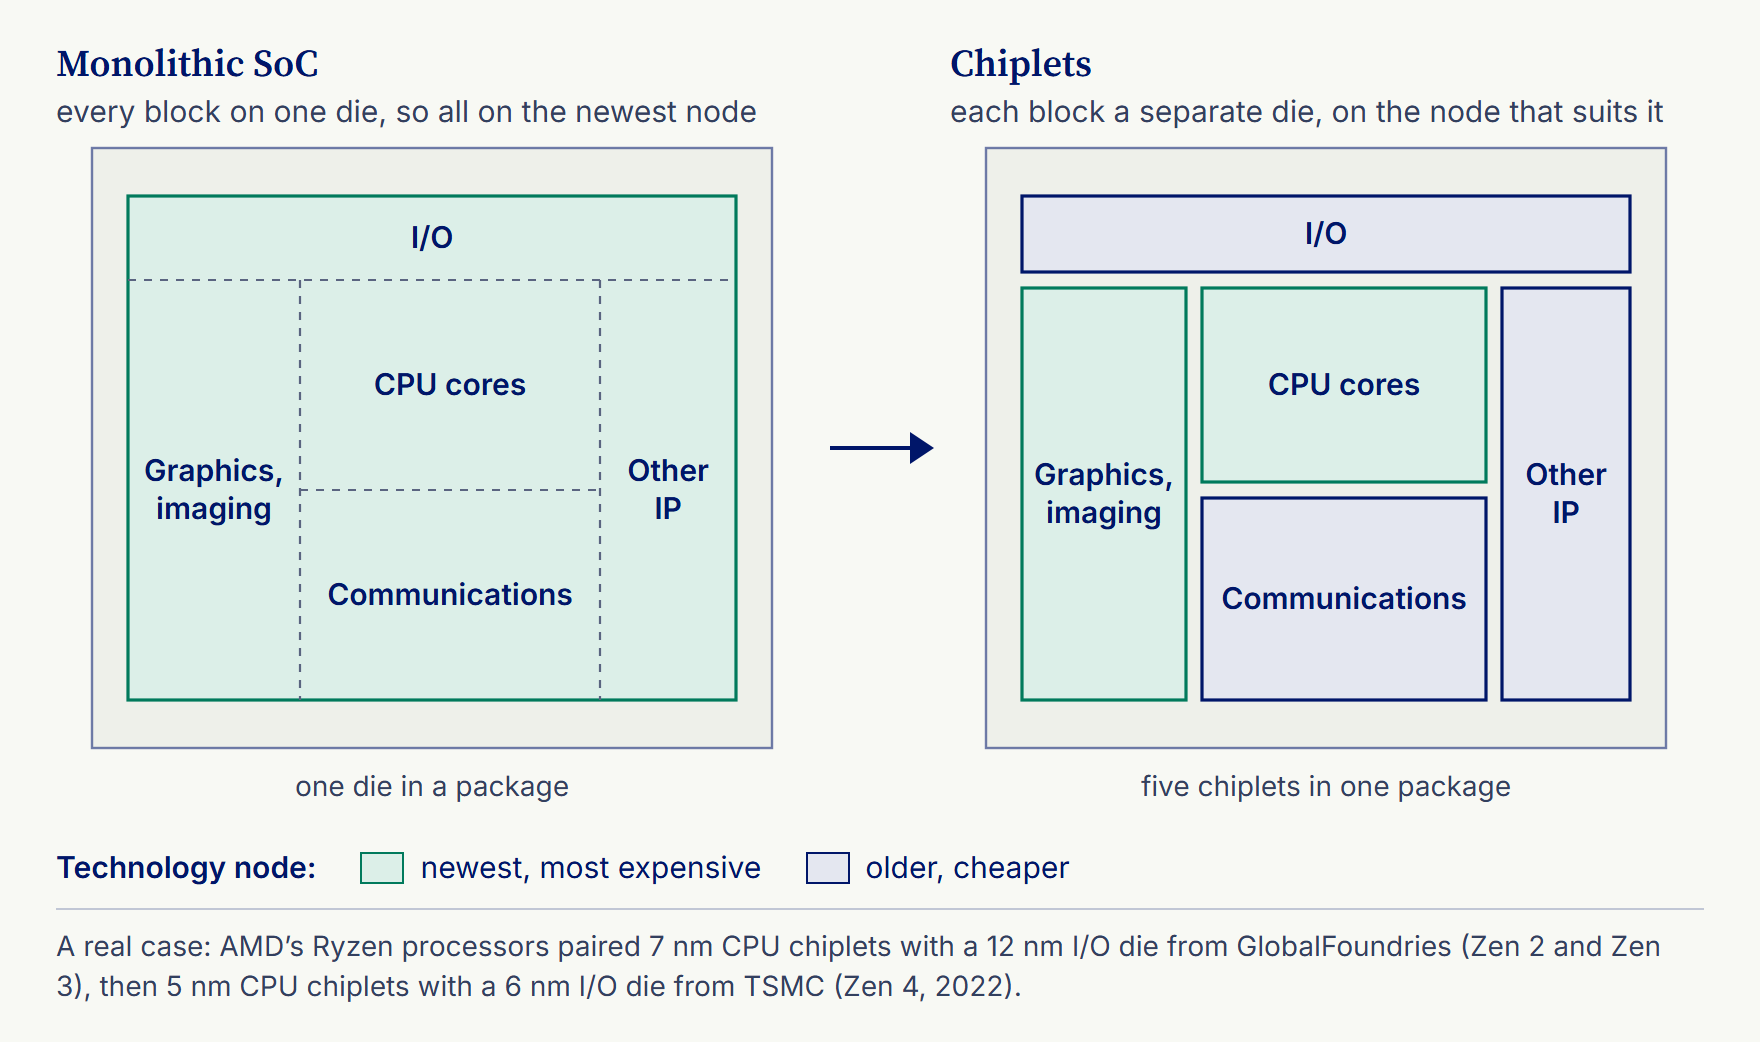
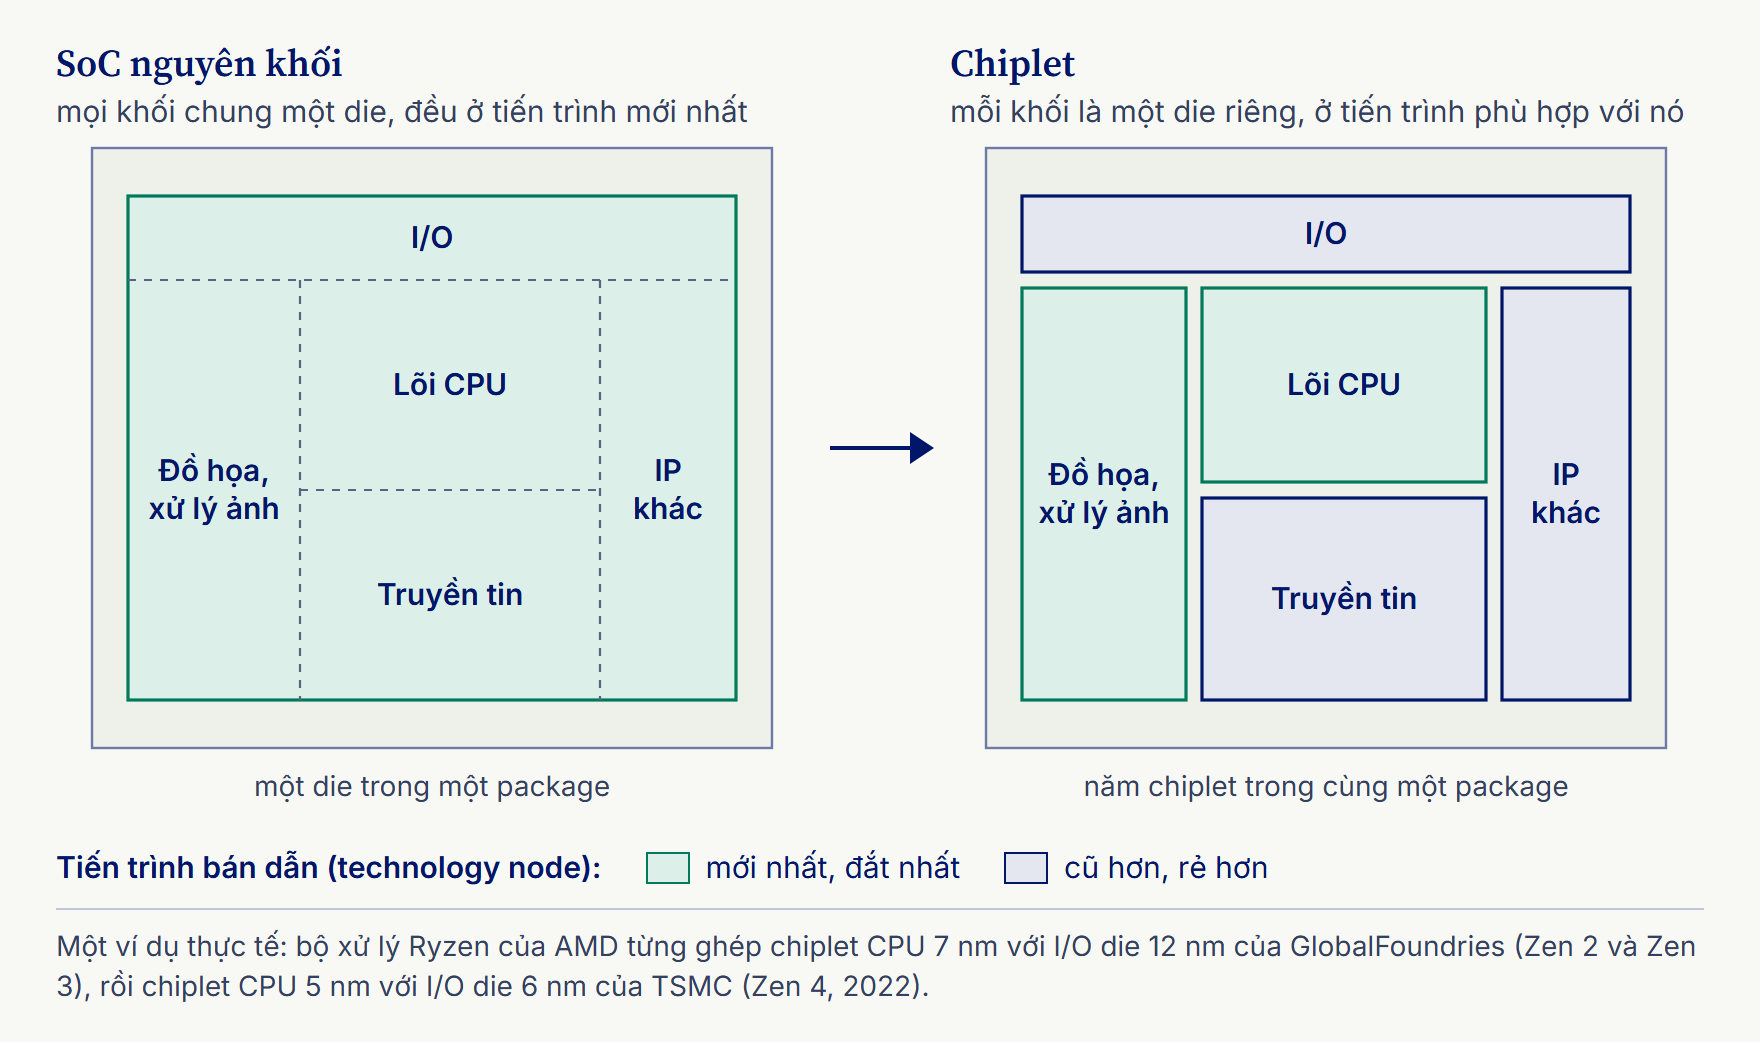
Put the two halves together and the design follows. Instead of one large SoC, the chip is built from several smaller dies, the chiplets, each made on the node that suits it: the processor cores and graphics on the newest, dearest node, and the I/O, communications and other blocks on older, cheaper ones (plate 1.3). A die that carries the chip’s links to the outside world, its input/output circuits and often its memory controllers, is called an I/O die.
Ghép hai nửa lý do ấy lại, cách thiết kế mới hiện ra. Thay vì một SoC lớn, con chip gồm nhiều die nhỏ hơn, tức các chiplet, mỗi chiplet làm trên tiến trình hợp với nó. Lõi xử lý và khối đồ họa nằm trên tiến trình mới nhất và đắt nhất; khối I/O, khối truyền tin và các khối khác nằm trên những tiến trình cũ hơn, rẻ hơn (hình 1.3). Một die mang các mạch nối con chip với bên ngoài, gồm mạch vào/ra và thường cả bộ điều khiển bộ nhớ, được gọi là I/O die.
Besides cost and yield, splitting helps the people who design the chip. Each chiplet can be designed and finished on its own schedule by the team that knows its field, analog and interface engineers on the I/O die and logic designers on the cores, instead of every block waiting for one huge die to be ready. And a proven chiplet can be used again: a company keeps an I/O die that already works and redesigns only the block that has to change. This is IP reuse, IP here meaning a finished block of design, and each reuse saves part of the NRE.
Ngoài chuyện chi phí và yield, tách chip còn giúp chính những người thiết kế. Mỗi chiplet có thể được thiết kế và hoàn thiện theo tiến độ riêng, do nhóm thạo đúng lĩnh vực ấy đảm nhận, thay vì mọi khối phải chờ một die khổng lồ hoàn tất. Kỹ sư analog và kỹ sư mạch giao tiếp lo I/O die, còn kỹ sư thiết kế logic lo các lõi. Một chiplet đã chạy tốt cũng có thể dùng lại: công ty giữ nguyên I/O die vốn đã hoạt động ổn định, chỉ thiết kế lại khối cần thay đổi. Cách làm này gọi là IP reuse (tái sử dụng khối thiết kế), với IP ở đây là một khối thiết kế đã hoàn chỉnh, và mỗi lần dùng lại như thế tiết kiệm được một phần NRE.
Joining dies made on different nodes, from different materials or by different companies in one package is called heterogeneous integration. Chapter 8 follows a processor whose chiplets are made by two companies.
Khi ghép vào cùng một package những die làm trên các tiến trình khác nhau, từ các vật liệu khác nhau hay do các hãng khác nhau sản xuất, người ta gọi đó là tích hợp dị thể (heterogeneous integration). Chương 8 sẽ xem xét một bộ xử lý có các chiplet do hai hãng sản xuất.
The package becomes part of the design
Khâu đóng gói chip trở thành một phần của thiết kế
Splitting a chip has a price. Inside a monolithic SoC, the blocks talk through the chip’s own fine wiring. Once they are separate dies, every signal between them has to leave one die, cross the package and enter another. Those links, the package’s interconnects, are usually far fewer and longer than on-chip wiring, and every crossing adds delay and costs energy.
Tách chip cũng có cái giá của nó. Trong một SoC nguyên khối, các khối trao đổi với nhau qua hệ thống dây dẫn rất mảnh ngay trên chip. Khi đã thành những die riêng, mọi tín hiệu giữa chúng phải rời một die, đi qua package rồi mới vào die kia. Những đường nối ấy, tức liên kết điện (interconnect) ở cấp đóng gói, thường ít hơn và dài hơn dây dẫn trên chip rất nhiều, và mỗi lần tín hiệu đi qua đều thêm độ trễ và tốn năng lượng.
So the package is no longer a box added at the end. How many connections it can make between dies, how short they are, and how much power and heat it can handle now decide whether a split chip works as well as one big one. Packaging that meets those needs, with connections far denser than before and processes borrowed from the fab, is called advanced packaging. At its high end, several dies are placed side by side or stacked close together.
Vì thế, package không còn là “cái hộp” gắn thêm vào sau cùng. Số kết nối mà package tạo được giữa các die, độ ngắn của các đường nối, lượng điện năng và nhiệt mà nó gánh nổi: những điều ấy giờ quyết định một con chip đã tách có chạy tốt như một con chip lớn hay không. Kiểu đóng gói đáp ứng được những đòi hỏi ấy, với các mối nối dày đặc hơn hẳn trước đây và những quy trình mượn từ fab, được gọi là đóng gói tiên tiến (advanced packaging). Ở mức cao nhất, nhiều die được đặt cạnh nhau hoặc xếp chồng sát nhau.
The rest of this book climbs that problem one rung at a time, following the connections as they shrink from pins 2.54 mm apart to copper-to-copper bonds less than 10 µm apart, and showing why each step was needed. Its last chapters ask who packages the world’s chips and where Vietnam, and its engineers, can enter. First, chapter 2 shows what every package does and how it is made.
Các chương sau lần lượt đi qua từng nấc của bài toán ấy. Chúng theo chân những kết nối ngày càng nhỏ lại, từ các chân cắm cách nhau 2,54 mm đến những mối nối đồng với đồng cách nhau chưa tới 10 µm, và cho thấy vì sao bước nào cũng cần thiết. Những chương cuối hỏi ai đang đóng gói chip cho thế giới, và Việt Nam cùng các kỹ sư của mình có thể bước vào từ đâu. Trước hết, chương 2 cho thấy package nào cũng phải làm những việc gì và được làm ra sao.